이 블로그에서 피지컬 AI를 다룰 때 “언어 지시를 팔 동작으로 바꾼다”는 표현을 썼다. 그 문장 한 줄이 실제로는 어떤 모델 구조를 뜻하는지가 지금 로보틱스에서 가장 빠르게 정리되고 있는 영역이다. 이름도 붙었다. VLA, 즉 Vision-Language-Action 모델이다.
입력은 화면과 문장, 출력은 관절값
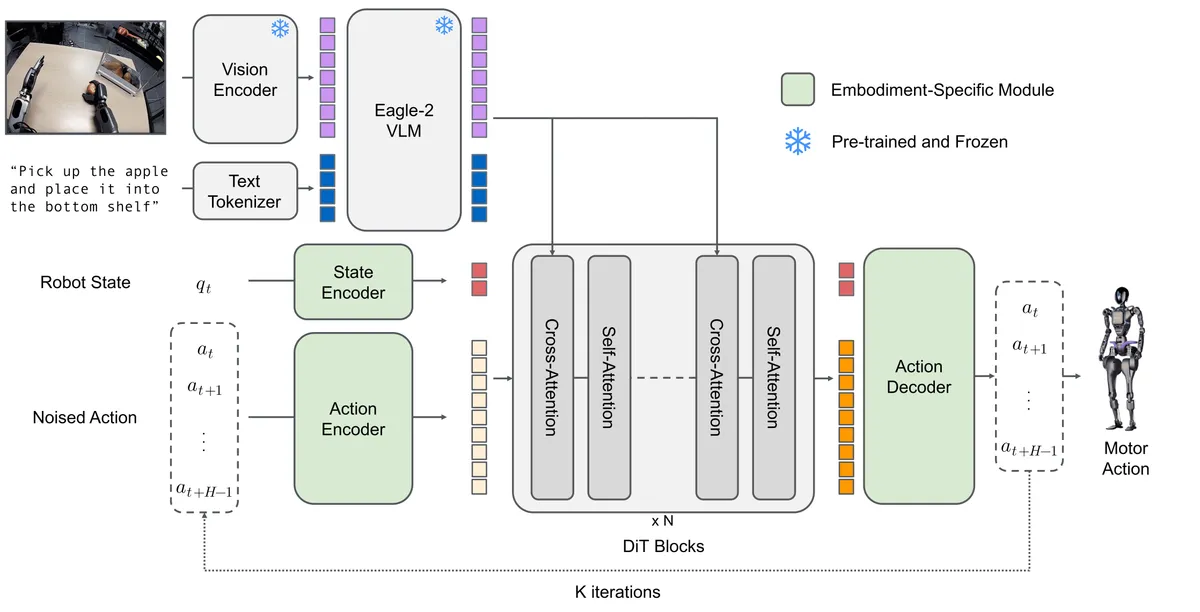
이름 그대로다. 카메라가 찍은 화면(Vision)과 사람이 내린 지시 문장(Language)을 함께 받아서, 로봇이 다음 순간 취할 동작(Action)을 내놓는다. 챗봇이 다음 토큰을 예측하듯 VLA는 다음 동작을 예측한다고 보면 가깝다.
차이는 출력의 성격에 있다. 언어 모델의 출력은 단어지만, VLA의 출력은 관절 각도나 그리퍼의 열림 정도처럼 물리량이다. 틀린 단어는 다시 쓰면 되지만 틀린 관절값은 물건을 떨어뜨린다.
왜 언어 모델을 가져다 쓰는가
VLA가 기존 로봇 제어와 갈라지는 지점은 출발점이다. 과거에는 작업마다 별도의 제어기를 설계했다. VLA는 이미 인터넷 규모의 이미지와 텍스트로 학습한 비전 언어 모델을 가져와, 그 위에 로봇 동작 데이터를 얹어 미세 조정한다.
이 순서에는 이유가 있다. “머그컵”이 무엇이고 “쏟지 말고”가 무슨 뜻인지는 로봇 데이터로 배우기에는 너무 비싸다. 반면 인터넷 데이터에는 그 지식이 이미 들어 있다. 로봇 데이터는 그 지식을 손끝으로 연결하는 데만 쓰는 것이다.
지금 이름이 오르내리는 모델들
| 모델 | 만든 곳 | 성격 |
|---|---|---|
| OpenVLA | 오픈소스 컨소시엄 | 7B 규모, 공개 데이터셋으로 학습된 공개 모델 |
| π 시리즈 | Physical Intelligence | 흐름(flow) 기반 동작 생성, 개방형 일반화를 목표 |
| Gemini Robotics | Google DeepMind | 자사 멀티모달 모델을 로봇 제어로 확장 |
| LeRobot | Hugging Face | 모델보다 학습·배포 도구와 데이터 형식 쪽에 무게 |
OpenVLA는 70만 건이 넘는 로봇 조작 에피소드로 학습됐다고 알려져 있다. π0.5 논문은 학습 때 본 적 없는 가정집에서도 지시를 수행하는 개방형 일반화를 목표로 내세웠는데, 이는 VLA 연구의 관심이 “정해진 작업을 잘하기”에서 “처음 보는 환경에서 버티기”로 옮겨갔음을 보여준다.
연산량이 곧 제어 주기다
VLA에는 언어 모델에 없는 제약이 하나 붙는다. 시간이다.
로봇 제어는 초당 수십 번 판단해야 하는 일인데, 수십억 개 파라미터 모델을 한 번 돌리는 데 1초가 걸리면 그 사이 로봇은 멈춰 있거나 이미 지나간 상황에 반응하게 된다. 그래서 VLA 연구의 상당 부분이 정확도가 아니라 지연 시간을 줄이는 데 쓰인다. 동작을 하나씩 내놓는 대신 여러 스텝을 묶어 한 번에 내놓는 방식(action chunking)이 널리 쓰이는 것도 같은 이유다.
언어 모델의 품질이 벤치마크 점수로 요약된다면, VLA의 품질은 점수와 제어 주기의 곱으로 봐야 한다. 아무리 정확해도 늦으면 쓸 수 없다.
실무자가 지금 알아둘 것
- 표준 형식이 잡히는 중이다. LeRobot 같은 도구가 서로 다른 로봇의 데이터를 같은 형식으로 묶으면서, 모델을 바꿔 끼우는 비용이 내려가고 있다.
- 범용 모델 하나로 끝나지 않는다. 현재 공개된 성과는 대부분 통제된 환경의 조작 작업이다. 공정 전체를 맡기는 단계와는 거리가 있다.
- 평가 기준이 아직 없다. 언어 모델의 벤치마크에 해당하는 합의된 척도가 로봇 쪽에는 정리되지 않았다. 업체가 제시하는 성공률은 과제와 환경 정의에 따라 달라진다.
정리
VLA는 인터넷에서 배운 지식을 가진 모델에 로봇 동작을 가르쳐, 말로 내린 지시를 물리 동작으로 바꾸는 접근이다. 언어 모델과 구조는 닮았지만 출력이 물리량이고 시간 제약이 붙는다는 점에서 성격이 다르다. 지금은 통제된 환경의 조작 작업에서 성과가 쌓이는 단계이고, 정확도만큼이나 제어 주기를 지키는 문제가 함께 풀려야 현장으로 넘어올 수 있는 것으로 보인다.