로봇 학습 데이터를 모으는 가장 싼 방법은 실제 로봇을 쓰지 않는 것이다. 가상 환경에서는 팔이 부러지지 않고, 밤새 수백만 번을 반복해도 전기 요금 외에 드는 비용이 없다. 문제는 그렇게 배운 정책을 실제 로봇에 올리는 순간 자주 무너진다는 데 있다. 이 간극을 부르는 이름이 sim-to-real gap이다.
시뮬레이션이 표준이 된 이유
피지컬 AI를 다룬 글에서 “실제 장비를 망가뜨리지 않고 수백만 번 시행착오를 반복할 수 있다”고 적었는데, 이 장점은 생각보다 크다. 실제 로봇 한 대가 하루에 만들 수 있는 시연은 수백 건이지만, GPU 위에서는 수천 개의 가상 로봇을 동시에 돌릴 수 있다.
무엇이 다르길래 깨지는가
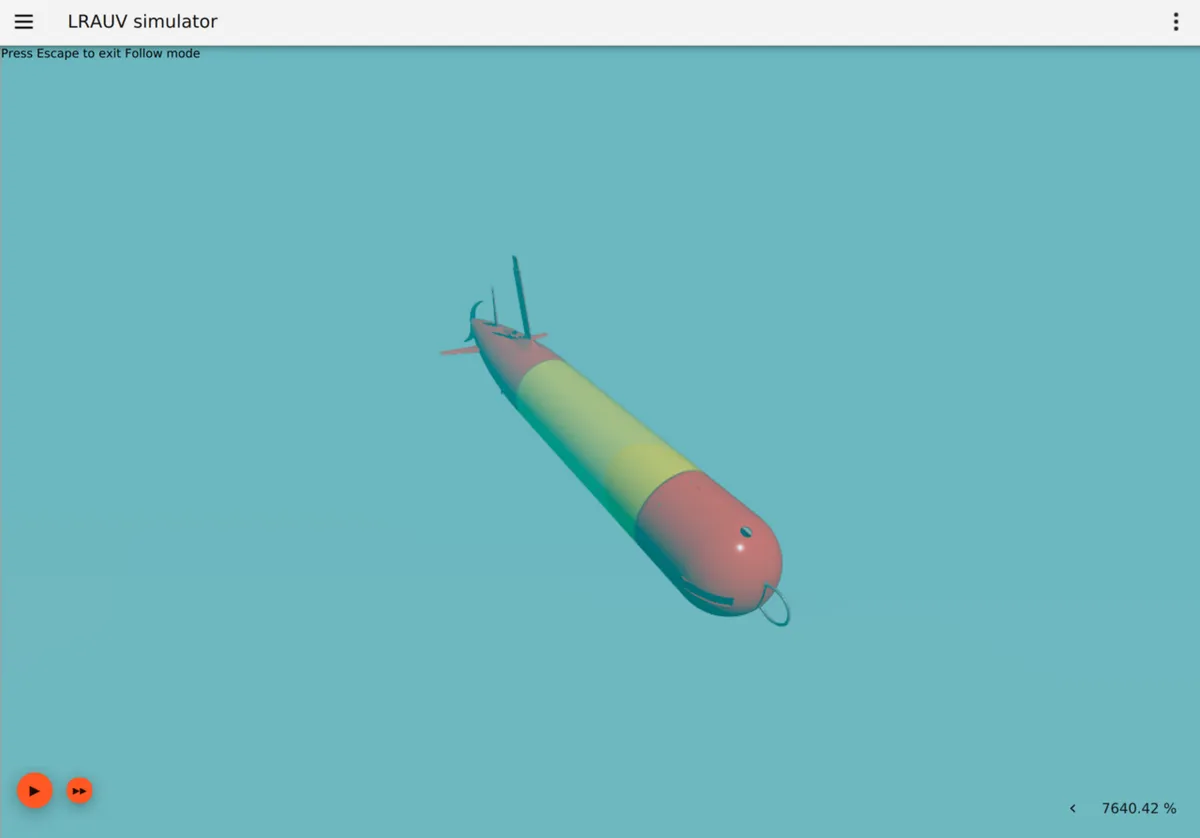
시뮬레이터는 현실의 근사값이다. 어긋나는 지점은 크게 둘로 나뉜다.
- 물리. 마찰 계수, 관절 마찰과 감쇠, 질량 분포, 접촉 순간의 변형. 특히 물체가 서로 닿는 순간의 계산은 시뮬레이터마다 결과가 다르다.
- 시각. 조명, 그림자, 재질의 반사, 카메라 노이즈. 가상 화면에서 또렷하게 보이던 물체가 실제 조명 아래에서는 다르게 잡힌다.
여기에 지연이라는 세 번째 차이가 있다. 시뮬레이터에서는 관측과 명령이 즉시 오가지만, 실제 로봇에는 센서 읽기, 추론, 모터 반응까지 각 단계의 지연이 누적된다.
도메인 랜덤화, 일부러 흔들어서 배우게 하기
가장 널리 쓰이는 해법은 시뮬레이터를 현실에 가깝게 만드는 것이 아니라, 반대로 시뮬레이터를 마구 흔드는 것이다. 마찰과 질량, 조명과 재질을 매 학습 회차마다 무작위로 바꾼다. 어떤 조건에서도 통하는 정책을 찾도록 강제하는 방식이다.
| 무작위로 바꾸는 것 | 노리는 효과 |
|---|---|
| 마찰, 질량, 관절 감쇠 | 물체와 로봇의 물성 차이에 둔감해짐 |
| 조명, 텍스처, 재질 | 현장 조명과 배경이 달라도 인식 유지 |
| 관측 노이즈, 지연 | 센서 품질과 제어 지연 차이를 흡수 |
| 제어기 게인 | 실제 모터 특성 편차에 대응 |
NVIDIA는 산업용 조립 작업에 이 방식을 적용하면서 로봇 동역학과 제어기 게인, 관측 노이즈를 함께 무작위화했다고 밝혔다. 정확한 물성값을 찾는 대신, 값이 틀려도 되는 정책을 찾는 접근이다.
시뮬레이션의 목표는 현실을 똑같이 흉내 내는 것이 아니라, 현실이 어느 쪽으로 틀어져도 버티는 정책을 만드는 것이다.
시뮬레이터를 두 개 쓰는 이유
현장에서는 시뮬레이터 하나로 끝내지 않는 경우가 많다. 시각 학습에는 렌더링이 좋은 쪽을, 물리 정책 최적화에는 접촉 계산이 빠른 쪽을 쓰는 식이다. 학습한 정책을 다른 시뮬레이터로 옮겨 다시 검증하는 절차(sim-to-sim)를 끼워 넣기도 한다. 현실로 나가기 전에 한 번 더 거르는 장치다.
정리
가상 환경 학습은 비용 때문에 선택되는 것이 아니라, 실제 로봇으로는 도달할 수 없는 반복 횟수 때문에 선택된다. 다만 시뮬레이터는 현실의 근사값이라 물리와 시각, 지연에서 차이가 생기고, 이를 메우는 표준 방법이 조건을 일부러 흔드는 도메인 랜덤화다. 시뮬레이터를 정교하게 만드는 쪽보다 정책을 둔감하게 만드는 쪽이 현재로서는 더 실용적인 방향으로 보인다.