모델 크기를 이야기할 때 숫자가 두 개씩 붙어 나오는 일이 잦아졌다. 671B인데 37B라든가, 46.7B인데 12.9B라는 식이다. 앞의 숫자는 모델이 가진 전체 파라미터이고 뒤는 토큰 하나를 처리할 때 실제로 계산에 참여하는 파라미터다. 이 두 숫자가 갈라지게 만드는 설계가 전문가 혼합, MoE다. 파라미터를 다룬 글에서 “전체는 많지만 일부만 활성화된다”는 한 줄로 짚고 넘어간 적이 있는데, 이 글에서는 그 일부가 어떻게 골라지고 무엇이 비용으로 돌아오는지까지 따라가 본다.
두 숫자가 각각 무엇을 결정하는가
실제 모델을 놓고 보면 차이가 선명하다.
| 모델 | 전체 파라미터 | 토큰당 활성 파라미터 | 전문가 구성 |
|---|---|---|---|
| Mixtral 8x7B | 46.7B | 12.9B | 전문가 8개 중 2개 선택 |
| DeepSeek-V3 | 671B | 37B | 층마다 전문가 다수 중 소수 선택 |
미스트랄 공식 발표는 Mixtral이 전체 46.7B 파라미터를 갖되 토큰당 12.9B만 쓴다고 설명한다. 매 층에서 라우터 네트워크가 8개 전문가 그룹 중 2개를 골라 토큰을 처리하고 그 출력을 더하는 방식이다. DeepSeek-V3 기술 보고서는 더 극단적이다. 전체 671B 가운데 토큰당 37B만 활성화한다고 밝히고 있다.
여기서 중요한 구분이 생긴다. 전체 파라미터는 메모리를 결정하고, 활성 파라미터는 연산량을 결정한다. 671B 모델을 돌리려면 671B를 전부 올려 둘 메모리가 필요하다. 가중치가 어디에 필요할지는 토큰이 들어와 봐야 알기 때문이다. 반면 한 토큰을 처리하는 연산은 37B짜리 모델과 비슷한 수준으로 끝난다. 덩치는 큰 모델인데 속도는 작은 모델에 가까운 조합이 이렇게 나온다.
라우터가 토큰마다 담당을 정한다
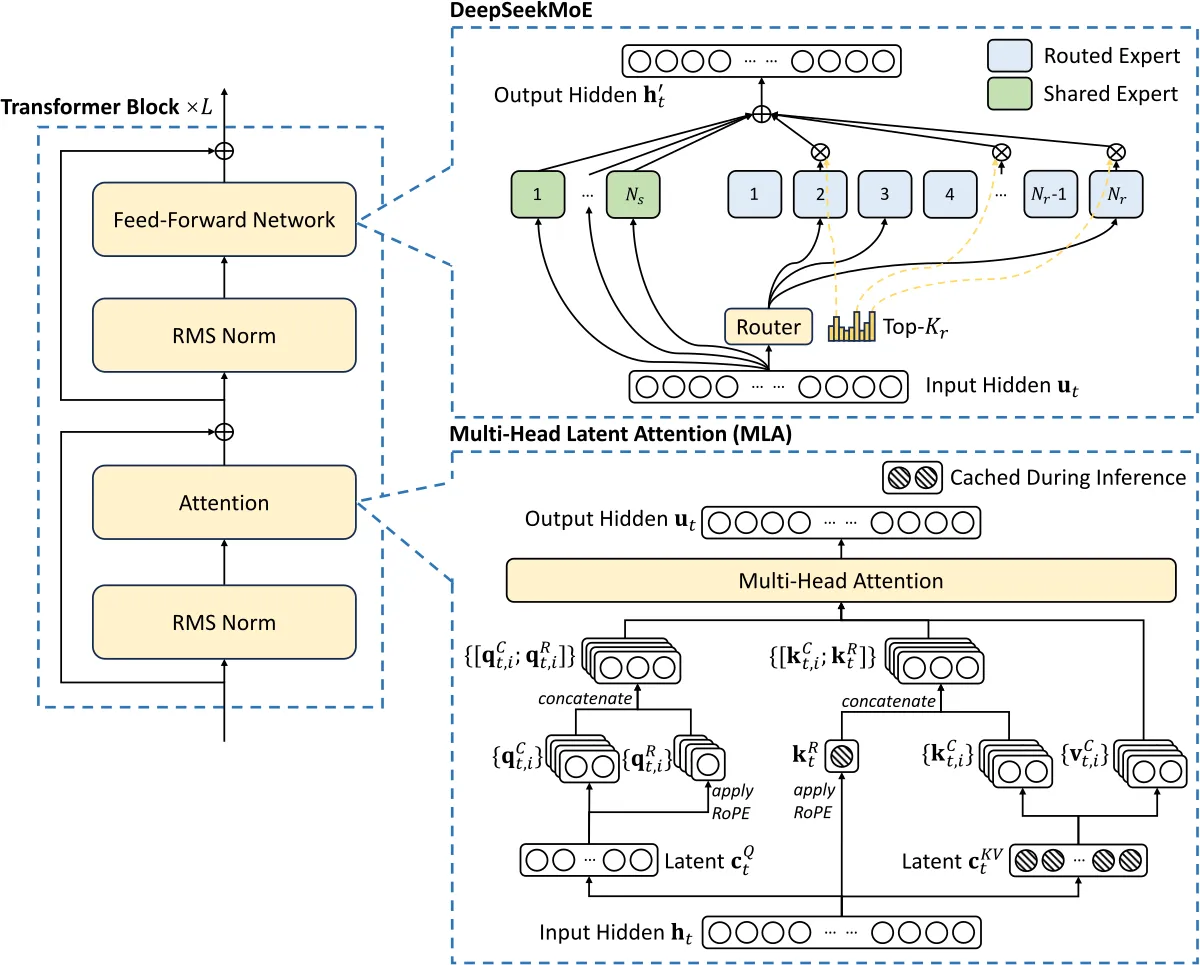
구조 자체는 단순하다. 트랜스포머의 피드포워드 층을 하나 두는 대신 같은 역할을 하는 전문가를 여러 개 두고, 그 앞에 라우터를 세운다. 라우터는 들어온 토큰을 보고 어느 전문가에게 보낼지 점수를 매긴다. 상위 몇 개가 선택되고, 각 전문가의 출력이 그 점수로 가중합된다.
선택은 토큰 단위로, 그리고 층마다 따로 일어난다. 문장 하나가 처리되는 동안 토큰마다 다른 전문가 조합을 거치고, 같은 토큰도 층을 올라가면서 담당이 바뀐다. 모델 전체를 몇 개 모듈로 나눠 놓고 질문 종류에 따라 하나를 고르는 식이 아니다.
전문가는 주제별로 나뉘지 않는다
이름 때문에 생기는 오해가 하나 있다. 전문가라는 말을 들으면 하나는 코드, 하나는 수학, 하나는 번역을 맡는 그림을 떠올리게 되는데, 실제로 학습된 전문가들은 그렇게 사람이 읽을 수 있는 경계로 갈라지지 않는 편이다. 분화는 일어나지만 암묵적으로 일어나고, 그 기준은 토큰 수준의 통계적 패턴에 가깝다.
실무적으로 이 점이 의미하는 바가 있다. “우리 도메인에 맞는 전문가만 떼어 쓰면 되지 않나” 같은 발상은 대체로 통하지 않는다. 전문가는 독립적으로 완결된 모듈이 아니라 라우터와 함께 학습된 부분이고, 떼어 내는 순간 그 조합을 전제로 만들어진 표현이 깨진다.
라우팅이 무너지는 방식
MoE 학습에서 반복해서 나오는 실패가 전문가 붕괴다. 라우터가 소수의 전문가에게만 토큰을 몰아주고 나머지는 거의 쓰이지 않는 상태로 수렴하는 현상이다. 이렇게 되면 전체 파라미터는 늘려 놨는데 실제로 학습되는 용량은 그 일부에 그친다. 메모리만 쓰고 효과는 못 보는 셈이다.
전통적인 대응은 보조 손실을 붙이는 것이다. 전문가 사용량이 고르게 퍼지도록 벌점을 주는 항을 목적 함수에 더한다. 다만 이 항이 본래 학습 목표와 충돌해 성능을 깎는다는 문제가 따라온다. DeepSeek-V3가 보조 손실 없는 부하 분산 방식을 내세운 것이 이 맥락이다. 손실 항을 더하는 대신 라우터가 내는 점수에 편향 값을 두고, 덜 쓰인 전문가 쪽으로 그 값을 조금씩 밀어 균형을 맞춘다.
비용 구조가 바뀐다
MoE는 공짜 점심이 아니라 비용의 종류를 바꾸는 선택에 가깝다. 연산은 줄지만 메모리 요구는 전체 파라미터를 따라가고, 여기에 더해 통신 부담이 새로 생긴다. 전문가들이 여러 장치에 흩어져 있으면 토큰을 담당 전문가가 있는 장치로 보내고 결과를 되받는 과정이 층마다 반복된다. 이 때문에 MoE 모델의 실제 처리량은 가속기를 잇는 인터커넥트 품질에 꽤 민감하다.
배치 구성에 따라 효율이 들쭉날쭉해지는 점도 운영에서 체감되는 부분이다. 한 배치 안의 토큰들이 서로 다른 전문가로 흩어지면 각 전문가가 처리하는 양이 적어져 장치 활용률이 떨어진다. 같은 모델인데 트래픽 패턴에 따라 토큰당 단가가 달라지는 이유가 여기에 있다.
모델을 고르는 입장에서 MoE 모델의 전체 파라미터 숫자는 홍보 문구에 가깝고, 실제로 봐야 할 것은 활성 파라미터와 필요한 메모리 두 가지다. 전자가 응답 속도를, 후자가 띄울 수 있느냐를 가른다.
정리
MoE는 파라미터와 연산을 분리하는 설계다. 같은 연산량으로 더 많은 지식을 담을 수 있다는 점에서 효율적이지만, 메모리는 전체 크기를 따라가고 통신과 부하 분산이라는 새로운 난이도가 생긴다. 모델 카드에 숫자 두 개가 적혀 있다면 둘 다 보되, 각각이 다른 제약을 뜻한다는 것만 기억하면 비교가 훨씬 쉬워진다.