사람이 쓴 공개 텍스트만으로는 다음 세대 모델을 키우기 어렵다는 경고가 나온 뒤로, 모델이 만든 데이터로 다음 모델을 학습시키는 방식이 실험이 아니라 표준 공정에 가까워지는 추세다. 사전 학습을 다룬 이전 글에서는 이 흐름을 한 문단으로 짚고 넘어갔지만, 실무에서 판단할 거리는 그보다 많다. 합성 데이터가 실제로 효과를 낸 영역은 어디인지, 그리고 모델이 자기 출력만 먹고 자라면 무엇이 무너지는지를 따로 떼어 정리한다.
사람이 쓴 텍스트가 모자라기 시작했다
연구기관 Epoch AI는 2024년 발표한 연구에서 학습에 쓸 만한 품질의 공개 인간 텍스트 총량을 약 300조 토큰으로 추산했다. 불확실성이 커서 90% 신뢰 구간은 100조에서 1,000조 토큰까지 넓게 잡혀 있다. 같은 연구는 지금의 확장 추세가 이어지면 2026년에서 2032년 사이에 이 재고를 다 쓰게 되고, 모델을 과하게 학습시키면 그 시점이 더 앞당겨질 수 있다고 내다봤다.
눈여겨볼 대목은 같은 연구가 합성 데이터에 대해 남긴 단서다. 합성 데이터가 능력을 확실히 끌어올린다는 근거는 아직 수학과 코딩처럼 비교적 좁은 영역에서만 확인됐다는 것이다. 데이터가 모자라니 합성 데이터로 채우면 된다는 식의 단순한 대체는 성립하지 않는다는 뜻으로 읽힌다.
이미 학습 공정 안에 들어와 있다
합성 데이터는 이미 주요 모델의 학습 단계 곳곳에 쓰이고 있다. 공개 자료로 확인되는 대표 사례는 다음과 같다.
| 사례 | 무엇을 합성했나 | 공개된 결과 |
|---|---|---|
| phi-1 (Microsoft, 2023) | GPT-3.5로 만든 교과서와 연습문제 10억 토큰, 선별한 웹 데이터 60억 토큰과 함께 사용 | 13억 파라미터 모델로 HumanEval 50.6%, MBPP 55.5% |
| Nemotron-4 340B (NVIDIA, 2024) | 지시 따르기와 선호 학습에 쓰는 정렬 데이터 | 정렬 단계 데이터의 98% 이상이 합성, 생성 파이프라인도 공개 |
| 검증 가능한 문제 풀이 | 수학 풀이, 코드와 테스트 | 정답 여부를 채점기로 걸러 맞는 풀이만 남기는 방식으로 널리 쓰임 |
공통점은 무작정 많이 만들어 붓지 않았다는 점이다. phi-1은 교과서처럼 짜인 고품질 텍스트를 목표로 생성했고, Nemotron은 보상 모델로 생성물에 점수를 매겨 상위 응답만 남겼다. 수학과 코드는 정답을 기계적으로 확인할 수 있어서 틀린 생성물을 버리기 쉽다. 합성 데이터가 효과를 낸 곳은 대체로 품질을 걸러낼 장치가 붙어 있던 곳이다.
모델 붕괴, 자기 출력만 먹으면 꼬리부터 사라진다
반대쪽 극단을 실험으로 보여 준 것이 2024년 7월 Nature에 실린 슈마일로프 연구팀의 모델 붕괴 논문이다. 연구팀은 언어 모델을 학습시킨 뒤 그 모델이 생성한 텍스트로 다음 세대 모델을 학습시키는 과정을 아홉 세대까지 반복했다. 결과는 세대가 지날수록 원래 데이터 분포의 가장자리, 즉 드물게 나오는 표현과 사례가 먼저 사라지는 것이었다. 모델은 흔한 것을 더 흔하게, 드문 것을 더 드물게 만들었고, 후반 세대에서는 같은 구절을 되풀이하는 출력이 흔해졌다. 연구팀은 이런 결함이 되돌리기 어렵다고 결론 내렸다.
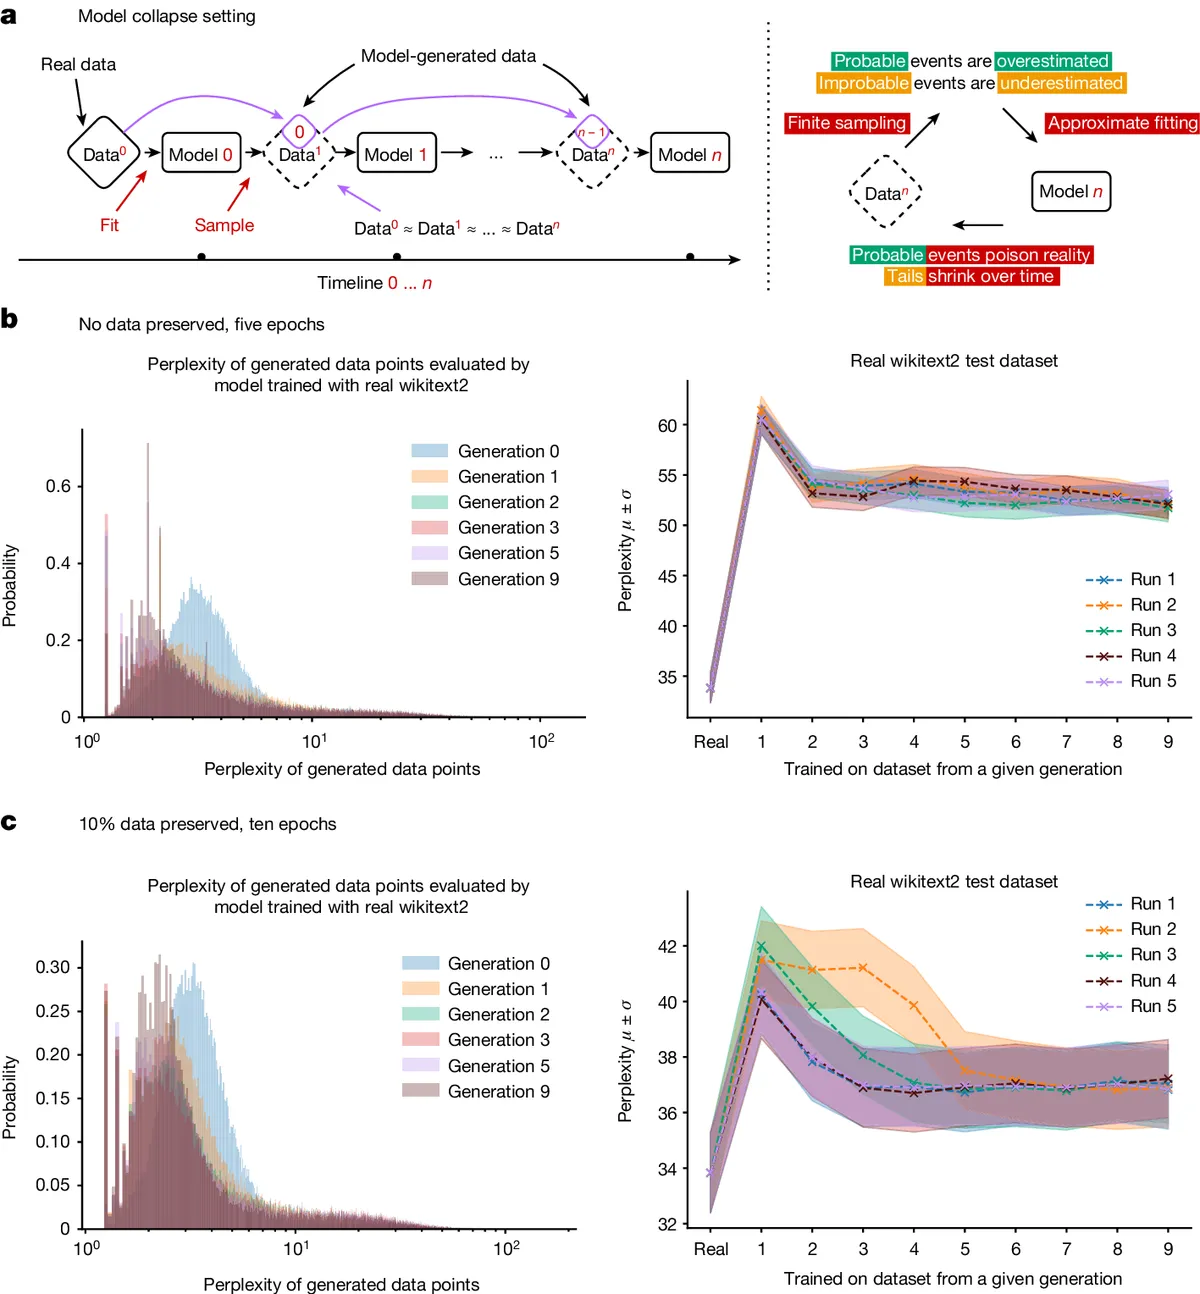
그림 오른쪽 그래프가 이 논문에서 실무적으로 가장 쓸모 있는 부분이다. 원본 데이터로 학습한 모델의 혼란도는 34 안팎이었다. 원본을 전혀 남기지 않고 생성 데이터만으로 세대를 이어 가면 혼란도가 50대에서 60 근처까지 올라갔다. 반면 매 세대 학습 데이터에 원본 10%를 남겨 두자 후반 세대의 혼란도는 37 안팎에 머물렀다. 무너지는 속도를 결정한 것은 합성 데이터의 존재 자체보다 원본이 얼마나 남아 있느냐였다.
교체하느냐, 쌓아 가느냐
같은 해 ICML에 발표된 게르슈트그라서 연구팀의 논문은 이 차이를 정면으로 다뤘다. 매 세대 실제 데이터를 합성 데이터로 갈아 끼우면 모델이 붕괴 쪽으로 가지만, 원본은 그대로 두고 세대마다 생긴 합성 데이터를 그 위에 쌓아 가면 오차가 일정 수준 이상으로 커지지 않는다는 결과다. 연구팀은 언어 모델 외에 이미지와 분자 구조 생성 모델에서도 비슷한 결과를 보고했다. 다만 합성 데이터를 아무 대가 없이 더할 수 있다는 해석에는 반론도 있다. 누적 조건에서도 성능 향상 속도가 둔해진다는 연구가 함께 나와 있어, 논쟁은 붕괴하느냐 마느냐보다 어떤 조건에서 얼마나 손해를 보느냐로 옮겨 간 모습이다.
합성 데이터의 위험은 모델이 만들었다는 사실보다, 사람이 만든 원본을 대체하는가와 검증 없이 섞이는가에 달린 것으로 보인다. 원본을 지키고 거르는 장치를 붙인 합성 데이터는 도구이고, 둘 다 없는 합성 데이터는 모델이 자기 그림자를 학습하는 일에 가깝다.
실무에서 합성 데이터를 쓸 때 확인할 것
- 원본을 버리지 않는다. 합성 데이터는 사람이 만든 데이터를 대신하는 재료가 아니라 그 위에 더하는 재료로 다룬다. 파인튜닝 데이터셋을 갱신할 때도 이전 버전의 원본은 남겨 둔다.
- 검증할 수 있는 곳부터 쓴다. 정답 판정이 가능한 분류, 추출, 코드, 계산 과제는 생성 후 걸러내기가 쉽다. 정답이 모호한 글쓰기나 상담 응답은 사람 검수 비율을 높게 잡는다.
- 출처를 기록한다. 어떤 샘플이 어느 모델로 생성됐는지 메타데이터로 남겨 두면, 나중에 품질 문제가 생겼을 때 그 부분만 걷어낼 수 있다. 웹에서 수집한 데이터에도 이미 다른 모델의 출력이 섞여 있다는 전제로 다룬다.
- 평균 점수 말고 다양성도 잰다. 모델 붕괴는 드문 사례부터 사라지기 때문에 평균 정확도에는 늦게 드러난다. 소수 카테고리, 긴 꼬리 질문에 대한 성능을 따로 떼어 추적한다.
정리
합성 데이터는 데이터 고갈을 해결하는 마법이라기보다, 정해진 조건에서만 잘 듣는 공정 도구로 보는 편이 정확하다. 효과가 확인된 사례는 모두 품질을 걸러내는 장치가 있었고, 붕괴가 관찰된 실험은 모두 원본을 합성물로 갈아 끼운 경우였다. 조직 안에서 모델을 다듬을 때도 같은 원칙이 통한다. 사람이 만든 원본을 기준점으로 지키고, 생성물은 걸러서 더하는 순서를 지키면 위험의 상당 부분은 관리 가능한 범위로 들어온다.