챗봇의 답이 한 글자씩 흘러나오는 모습은 연출이 아니라 언어 모델이 실제로 일하는 방식이다. 모델은 다음 토큰 하나를 고르고, 그 토큰을 붙인 문장을 다시 읽어 그다음 토큰을 고른다. 이 순서를 바꾸지 않으면서 기다리는 시간만 줄이는 기법이 추측 디코딩(speculative decoding)이다. 작은 모델이 몇 토큰을 먼저 써 두면, 큰 모델이 그 초안을 한 번에 검토해 맞는 부분까지 승인한다. 2022년 말과 2023년 초에 구글과 딥마인드가 잇달아 발표한 뒤, 지금은 주요 추론 엔진에 기본 기능으로 들어가 있다.
느린 이유는 계산이 아니라 기다림이다
큰 모델이 토큰 하나를 만들 때마다 수십~수백 GB의 가중치를 메모리에서 GPU 연산 장치로 옮겨야 한다. 정작 계산은 금방 끝나고, 대부분의 시간은 이 데이터를 실어 나르는 데 쓰인다. 업계에서는 이 상태를 “메모리 대역폭에 묶여 있다”고 표현한다.
여기서 중요한 관찰이 나온다. 가중치를 한 번 불러온 김에 토큰 하나만 계산하든 다섯 개를 동시에 계산하든 걸리는 시간이 크게 다르지 않다. 문제는 다음 토큰이 앞 토큰에 달려 있어서, 아직 모르는 다섯 개를 한꺼번에 계산할 방법이 없다는 점이다. 추측 디코딩은 그 다섯 개를 다른 누군가가 미리 추측해 주면 된다는 데서 출발한다.
초안을 쓰고, 한 번에 검토한다
동작은 세 단계로 나뉜다.
- 초안 작성. 같은 어휘를 쓰는 작고 빠른 모델(드래프트 모델)이 다음 토큰 몇 개를 차례로 생성한다. 작은 모델이라 몇 개를 써도 큰 모델의 한 단계보다 짧게 걸린다.
- 일괄 검토. 큰 모델(타깃 모델)이 초안 전체를 한 번의 계산으로 읽고, 각 위치에서 자신이 고를 토큰의 확률을 동시에 구한다.
- 승인과 수정. 앞에서부터 초안 토큰을 하나씩 확인해 받아들이다가, 처음으로 어긋나는 위치에서 멈추고 그 자리는 큰 모델의 선택으로 바꾼다. 그 뒤의 초안은 버리고 다시 1단계로 돌아간다.
초안이 잘 맞으면 큰 모델의 계산 한 번으로 토큰 여러 개가 확정되고, 하나도 맞지 않아도 최소 한 개는 큰 모델이 직접 만든 토큰으로 진행된다. 손해를 보는 경우는 초안을 쓰는 데 든 시간 정도다.
왜 답이 바뀌지 않는가
추측 디코딩의 핵심 주장은 “출력 분포가 큰 모델 단독으로 생성할 때와 같다”는 것이다. 구글 리서치의 레비아탄, 칼만, 마티아스가 ICML 2023에서 발표한 원 논문은 초안 토큰을 확률 비율에 따라 받아들이거나 거절하고, 거절된 자리에서는 보정된 분포로 다시 뽑는 방식(변형된 거절 샘플링)을 쓰면 결과의 분포가 수학적으로 동일하다는 것을 보였다. 같은 논문은 T5-XXL에서 출력은 그대로 두고 표준 구현보다 2~3배 빠른 생성 속도를 보고했다.
비슷한 시기 딥마인드도 같은 아이디어를 추측 샘플링(speculative sampling)이라는 이름으로 발표했다. 700억 파라미터 규모의 친칠라 모델에서 요약(XSum)과 코드 생성(HumanEval) 과제의 디코딩 속도가 2~2.5배 빨라졌고, 품질 저하는 없었다고 보고했다. 두 연구 모두 기존 모델을 다시 학습하거나 구조를 바꿀 필요가 없다는 점을 강조했다.
추측 디코딩은 답의 품질과 속도를 맞바꾸지 않는다. 양자화나 증류가 모델 자체를 가볍게 만드는 대신 정확도를 조금 내주는 것과 달리, 이 기법은 같은 답을 더 빨리 받는 방법이다.
초안을 누가 쓰는가
처음에는 같은 계열의 작은 모델을 따로 두는 방식이 기본이었지만, 별도 모델을 함께 띄우는 부담을 줄이려는 변형이 이어졌다.
| 방식 | 초안 작성자 | 특징 |
|---|---|---|
| 드래프트 모델 | 같은 어휘를 쓰는 작은 모델 | 구현이 단순하지만 두 모델을 함께 메모리에 올려야 한다 |
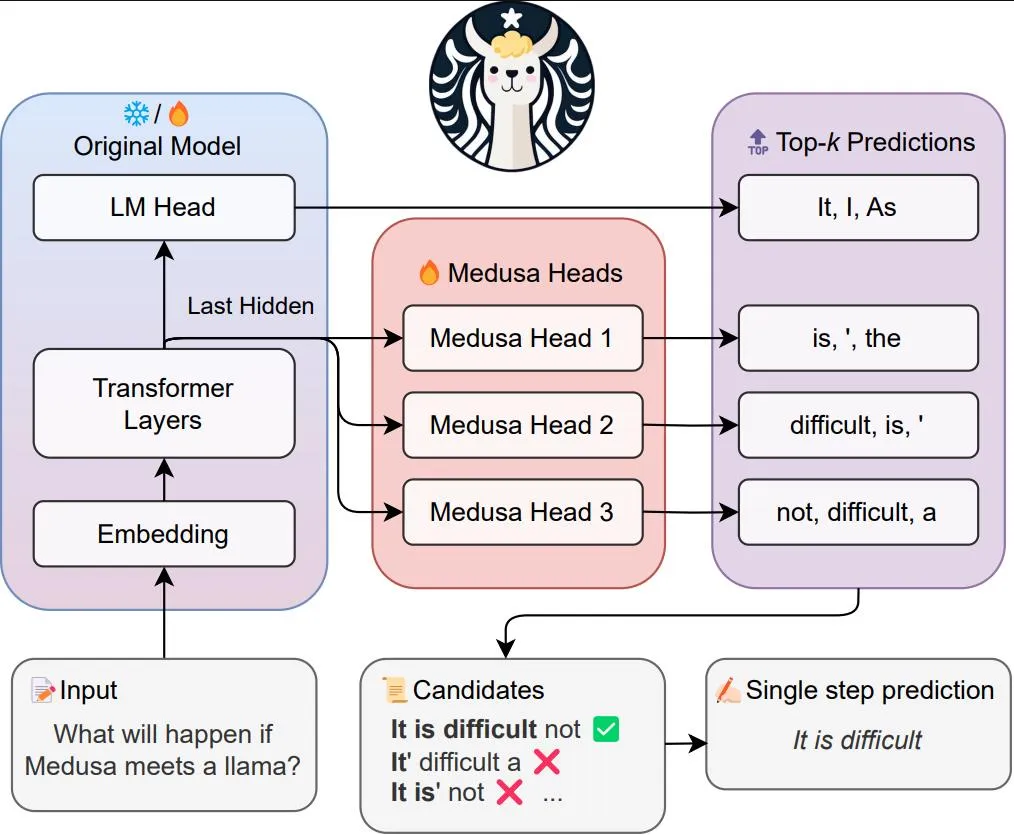
| Medusa | 큰 모델에 덧붙인 예측 헤드 여러 개 | 별도 모델 없이 몇 칸 앞의 토큰을 동시에 예측한다 |
| EAGLE 계열 | 큰 모델의 내부 표현을 입력으로 받는 얕은 초안 네트워크 | 초안의 적중률이 높은 편이라 최근 추론 엔진에서 많이 쓰인다 |
| n-gram 조회 | 프롬프트 안에 이미 있는 문자열 | 모델 없이 입력 문장을 그대로 베끼는 구간(요약, 코드 수정)에서 효과적이다 |
Medusa는 원래 모델의 마지막 은닉 상태에 작은 헤드 여러 개를 붙여, 첫 번째 헤드는 한 칸 뒤, 두 번째 헤드는 두 칸 뒤 토큰을 예측하게 한다. 각 헤드가 내놓은 후보를 조합해 여러 갈래의 초안을 만들고, 큰 모델이 그중 가장 길게 맞는 갈래를 한 번에 고른다.
효과가 줄어드는 조건
속도 향상 폭은 결국 초안이 얼마나 자주 맞느냐(수락률)에 달려 있다. 그래서 같은 기법이라도 상황에 따라 체감이 크게 달라진다.
- 창의적인 글과 높은 온도. 다음 단어의 선택지가 넓을수록 작은 모델이 큰 모델의 선택을 맞히기 어렵다. 정해진 형식의 코드나 요약처럼 예측 가능한 출력에서 효과가 크다.
- 요청이 몰리는 서버. 사용자 요청을 크게 묶어 처리하는 서버는 이미 GPU 연산을 꽉 채우고 있어, 남는 계산을 초안 검토에 쓰는 이점이 줄어든다. 동시 사용자가 적고 응답 지연이 중요한 서비스에서 더 유리하다.
- 추가 메모리와 운영 부담. 별도 드래프트 모델은 그만큼 GPU 메모리를 차지하고, 큰 모델을 바꿀 때마다 짝이 맞는 초안 모델도 다시 골라야 한다.
- 초안 길이의 조율. 초안을 길게 쓸수록 한 번에 얻을 수 있는 토큰은 늘지만, 뒤로 갈수록 틀릴 확률도 올라간다. 추론 엔진들은 수락률을 지표로 보여 주고 초안 길이를 조정하게 한다.
실무에서 보는 포인트
API로 모델을 쓰는 입장에서는 추측 디코딩을 직접 켤 일이 거의 없다. 모델 제공사가 서버 쪽에서 이미 적용하고 있는 경우가 많고, 결과가 바뀌지 않으니 사용자 입장에서는 응답이 빨라진 것으로만 드러난다. 직접 모델을 서빙하는 팀이라면 이야기가 다르다. vLLM, TensorRT-LLM, SGLang 같은 추론 엔진이 드래프트 모델, EAGLE, n-gram 방식을 설정값으로 제공하므로, 자기 서비스의 실제 요청으로 수락률과 지연 시간을 재 보고 고르는 것이 순서다.
비용 관점에서도 의미가 있다. 같은 GPU로 더 짧은 시간에 응답을 끝내면, 실시간 상담이나 코드 자동완성처럼 지연에 민감한 서비스를 더 적은 장비로 운영할 수 있다. 에이전트처럼 모델을 여러 번 연달아 부르는 구조에서는 단계마다 줄어든 시간이 누적되어 전체 작업 시간 차이가 더 크게 벌어진다.
정리
추측 디코딩은 작은 모델이 초안을 쓰고 큰 모델이 한 번에 검토하는 방식으로, 메모리를 기다리느라 놀던 GPU 계산을 활용해 생성 속도를 높인다. 출력 분포는 큰 모델 단독과 같아서 품질을 내주지 않는다는 점이 다른 경량화 기법과 구별된다. 다만 효과는 초안의 적중률과 서비스의 부하 형태에 크게 좌우되므로, 숫자는 논문이 아니라 자기 요청으로 재 봐야 한다.