
このブログでフィジカルAIを取り上げたとき、「言葉の指示をアームの動きに変える」と書きました。その一文が実際にどのようなモデル構造を指すのかは、いまロボティクスでもっとも速く整理が進んでいる領域です。名前もつきました。VLA、つまりVision-Language-Actionモデルです。
入力は映像と文章、出力は関節の値
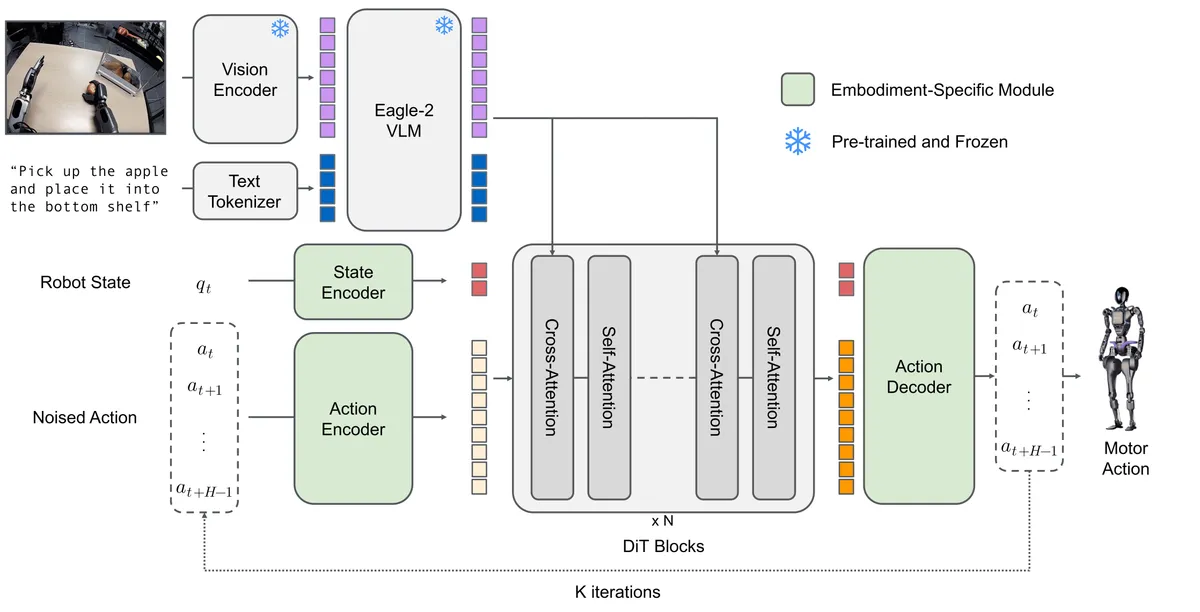
名前のとおりの仕組みです。カメラが映した映像(Vision)と人が出した指示文(Language)をあわせて受け取り、ロボットが次の瞬間にとる動作(Action)を出力します。チャットボットが次のトークンを予測するように、VLAは次の動作を予測すると考えると近いでしょう。
違いは出力の性質にあります。言語モデルの出力は単語ですが、VLAの出力は関節の角度やグリッパーの開き具合といった物理量です。間違えた単語は書き直せば済みますが、間違えた関節の値は物を落とします。
なぜ言語モデルを土台にするのか
VLAが従来のロボット制御と分かれるのは出発点です。かつては作業ごとに専用の制御器を設計していました。VLAは、インターネット規模の画像とテキストですでに学習した視覚言語モデル(VLM)を持ってきて、その上にロボットの動作データを載せてファインチューニングします。
この順番には理由があります。「マグカップ」が何で、「こぼさないように」がどういう意味かをロボットのデータで学ばせるのは、コストがかかりすぎます。一方、インターネットのデータにはその知識がすでに入っています。ロボットのデータは、その知識を手先の動きにつなぐためだけに使うわけです。
いま名前がよく挙がるモデル
| モデル | 開発元 | 特徴 |
|---|---|---|
| OpenVLA | オープンソースのコンソーシアム | 7B規模、公開データセットで学習した公開モデル |
| πシリーズ | Physical Intelligence | フロー(flow)ベースの動作生成、オープンな汎化が目標 |
| Gemini Robotics | Google DeepMind | 自社のマルチモーダルモデルをロボット制御に拡張 |
| LeRobot | Hugging Face | モデルよりも学習・デプロイのツールとデータ形式に重点 |
OpenVLAは70万件を超えるロボット操作のエピソードで学習したとされています。π0.5の論文は、学習時に見たことのない一般家庭でも指示をこなすオープンな汎化を目標に掲げました。VLA研究の関心が「決まった作業をうまくこなす」から「初めて見る環境でも崩れない」へ移ったことを示しています。
計算量がそのまま制御周期になる
VLAには、言語モデルにはない制約がひとつ加わります。時間です。
ロボット制御は1秒間に数十回の判断が必要な仕事です。数十億パラメータのモデルを1回動かすのに1秒かかれば、その間ロボットは止まっているか、すでに過ぎた状況に反応することになります。そのため、VLA研究のかなりの部分が精度ではなく遅延を減らすことに充てられています。動作をひとつずつ出す代わりに複数ステップをまとめて一度に出す方式(アクションチャンキング、action chunking)が広く使われているのも同じ理由です。
言語モデルの品質がベンチマークのスコアで要約されるなら、VLAの品質はスコアと制御周期の掛け算で見るべきです。どれだけ正確でも、遅ければ使えません。
実務担当者がいま押さえておきたいこと
- 標準形式が固まりつつある。 LeRobotのようなツールが異なるロボットのデータを同じ形式にまとめることで、モデルを差し替えるコストが下がっています。
- 汎用モデルひとつでは終わらない。 現在公開されている成果の大半は、管理された環境での操作作業です。工程全体を任せる段階とはまだ距離があります。
- 評価基準がまだない。 言語モデルのベンチマークにあたる合意された尺度が、ロボットの分野では整っていません。メーカーが示す成功率は、タスクと環境の定義しだいで変わります。
まとめ
VLAは、インターネットで学んだ知識を持つモデルにロボットの動作を教え、言葉で出した指示を物理的な動作に変えるアプローチです。構造は言語モデルに似ていますが、出力が物理量で時間の制約がつく点で性格が異なります。いまは管理された環境の操作作業で成果が積み上がっている段階で、精度と同じくらい制御周期を守る問題も解かなければ、現場には移ってこないとみられます。