
言語モデルが急速に良くなった理由をひとつだけ挙げるなら、データです。インターネットに蓄積されたテキストを集めるだけで、兆単位のトークンを確保できました。ロボットは事情が正反対です。「コップをつかんで移す動作」は、インターネットのどこにも関節の値の形では保存されていません。
ロボットのデータはつくらなければ生まれない
テキストは誰かがすでに書いたものを集めればよいのに対し、ロボットのデータは実際にロボットを動かさないと生まれません。人がコントローラーを握って1回デモをすれば1件、もう一度やれば2件です。
そこに、ロボットごとにアームの長さや関節の数、グリッパーの形が違うという問題が重なります。ロボットAで集めたデータを、ロボットBはそのまま使えません。言語モデルの世界にたとえるなら、データを集めるコストが高いうえに、集めたデータが別のモデルでは読めない状況に近いといえます。
複数の研究室がデータを持ち寄り始めた
この問題に正面から取り組む代わりに、回り道をしたのが共同データセットです。代表例がOpen X-Embodimentで、世界中のロボット研究室がそれぞれ集めたデータセットをひとつの形式にまとめました。
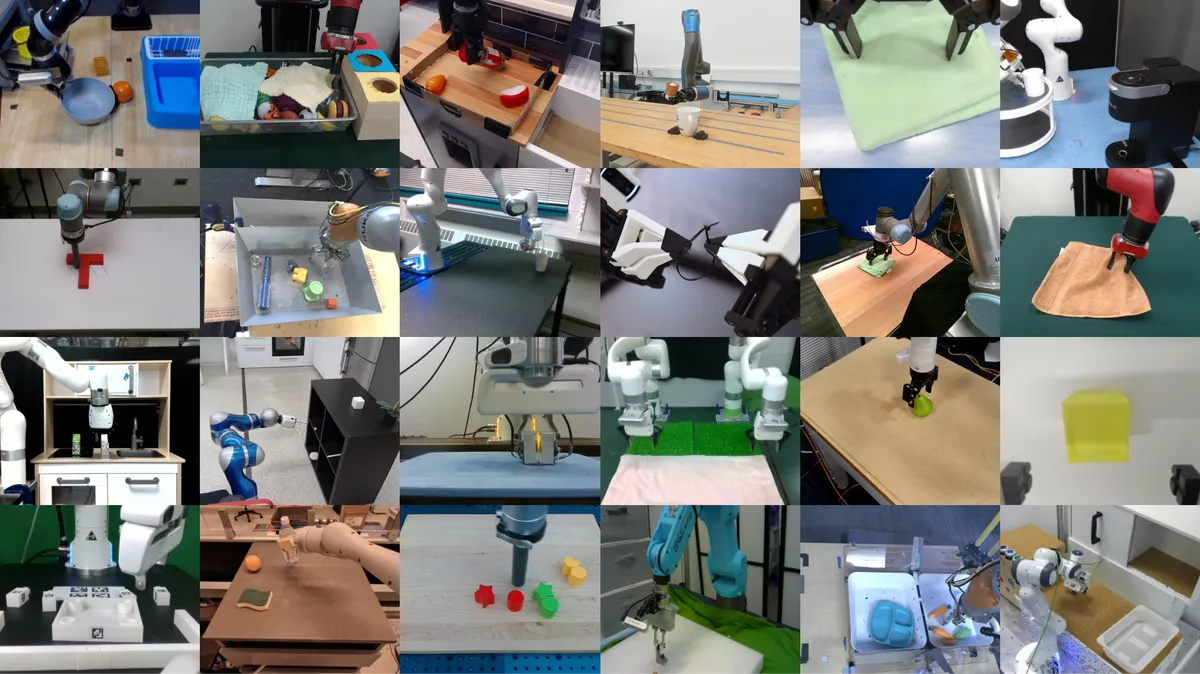
プロジェクトの公開資料によると、このデータセットは数十の機関の既存データセットを集め、100万件を超える実ロボットの軌跡と、20種あまりのロボット形態を収めています。ひとつの研究室が何年かけても届きにくい規模を、すでに散らばっていたデータを統合することでつくったわけです。
| アプローチ | データの入手方法 | 限界 |
|---|---|---|
| 自前で収集 | 人がロボットを操縦してデモ | 遅く、コストが高い |
| 共同データセット | 機関ごとのデータをひとつの形式に統合 | ロボットの種類と品質がばらばら |
| シミュレーション | 仮想環境でいくらでも生成 | 現実との差を埋める必要がある |
| 人の映像 | 人が作業する映像から抽出 | 関節の値ではないため変換が必要 |
量より多様性が効く可能性
データを統合するなかで見えてきたのは、単純な量より多様性が性能を左右するという点です。同じ部屋で同じコップを1万回つかんだデータより、いくつもの建物、いくつもの照明条件で別々の物をつかんだデータのほうが、初めて見る環境ではるかに崩れにくくなります。
DROIDのように、数百のシーンと数十の建物で同じ規格のロボットアームを使って集めたデータセットが注目されたのも、ここに理由があります。ロボットはひとつに固定し、環境のほうを散らした設計です。
ロボットデータの価値は件数ではなく、「何通りの状況を経験したか」で測るほうが実際の性能に近くなります。
実務に残る示唆
- データが参入障壁(モート)になる。 現場でロボットを動かす企業は、モデルをつくらなくてもデータを蓄積していきます。この資産の所有権と活用範囲は、契約書で前もって決めておくほうが安全です。
- まず形式をそろえる。 機器ごとにログの形式がばらばらだと、あとで統合するときにコストがかかります。収集の初期に形式を合わせておくほうが安く済みます。
- 公開データは出発点であって正解ではない。 共同データセットは一般的な操作能力を引き上げますが、特定の工程の成功率は、結局その現場のデータでファインチューニングしないと上がりません。
まとめ
ロボット学習のボトルネックは、モデルの構造よりデータの側にあります。インターネットから集められない種類のデータで、ロボットごとに形式が違うため再利用も難しいからです。複数の機関がデータを統合し形式をそろえる流れは、この限界を回避する現実的な方法とみられます。量より多様性が性能を左右するという観察が、収集戦略の基準になりつつあります。