
モデルの大きさを語るとき、数字が2つ並んで出てくることが増えました。671Bなのに37B、46.7Bなのに12.9Bといった具合です。前の数字はモデルが持つ総パラメータ、後ろはトークン1つを処理するときに実際に計算に加わるパラメータです。この2つの数字を分ける設計が、Mixture of Experts(MoE)です。パラメータを扱った記事では「全体は多いが、一部だけが活性化される」と一行で触れるにとどめましたが、この記事ではその一部がどう選ばれ、何がコストとして返ってくるのかまで追っていきます。
2つの数字はそれぞれ何を決めるのか
実際のモデルで比べると、違いがはっきりします。
| モデル | 総パラメータ | トークンあたりのアクティブパラメータ | エキスパートの構成 |
|---|---|---|---|
| Mixtral 8x7B | 46.7B | 12.9B | 8個のエキスパートから2個を選択 |
| DeepSeek-V3 | 671B | 37B | 層ごとに多数のエキスパートから少数を選択 |
Mistral AIの公式発表は、Mixtralが総パラメータ46.7Bを持ちながら、トークンあたり12.9Bしか使わないと説明しています。各層でルーターネットワークが8つのエキスパートのグループから2つを選んでトークンを処理し、その出力を足し合わせる方式です。DeepSeek-V3のテクニカルレポートはさらに極端で、総パラメータ671Bのうちトークンあたり37Bだけを活性化すると明かしています。
ここで大事な区別が生まれます。総パラメータはメモリを決め、アクティブパラメータは計算量を決めます。 671Bのモデルを動かすには、671Bをすべて載せておけるメモリが必要です。どの重みが必要になるかは、トークンが入ってくるまでわからないからです。一方で、1トークンを処理する計算は37B規模のモデルと同じくらいで済みます。図体は大きいのに、速度は小さいモデルに近い。そんな組み合わせはこうして生まれます。
ルーターがトークンごとに担当を決める
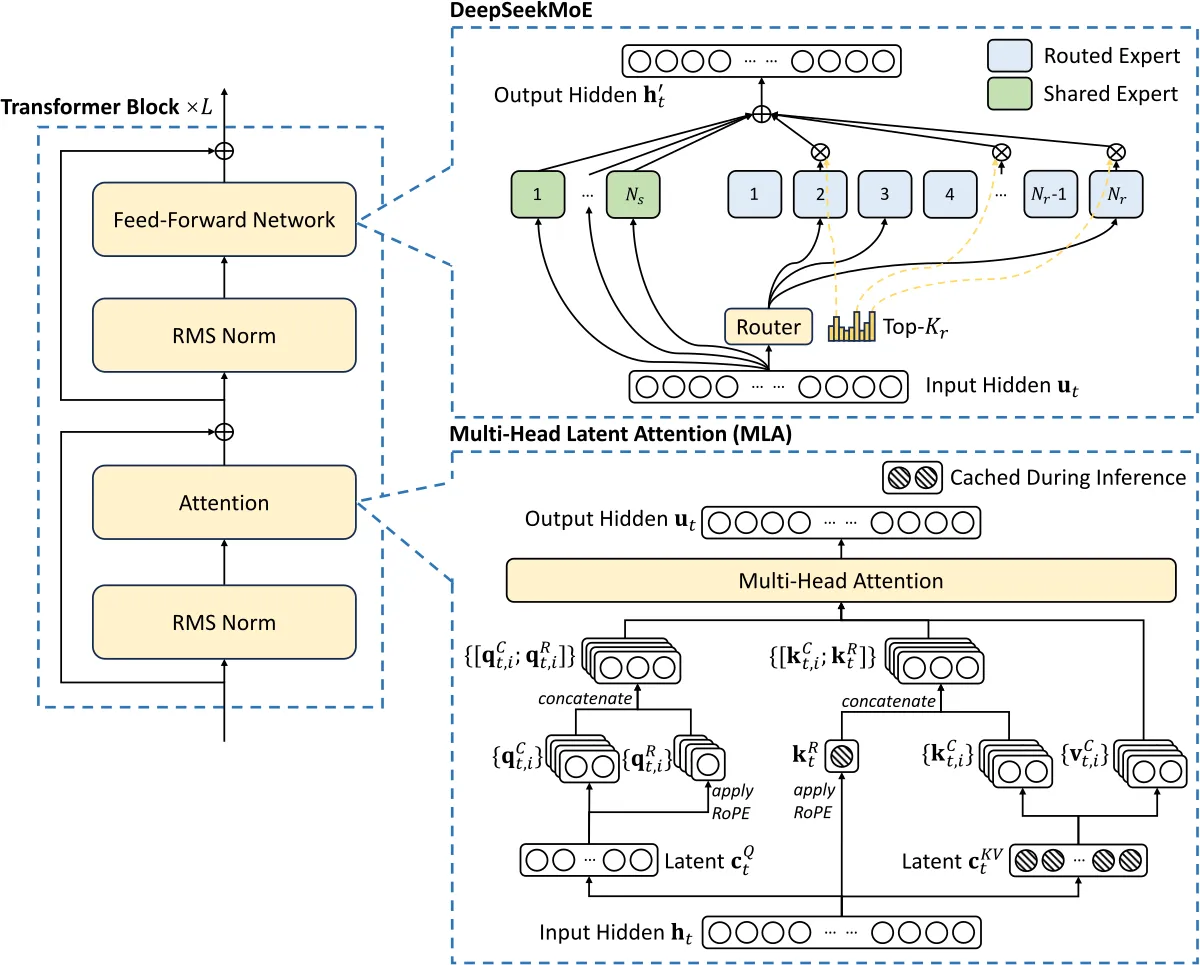
構造そのものはシンプルです。Transformerのフィードフォワード層を1つ置く代わりに、同じ役割を持つエキスパートを複数並べ、その手前にルーターを置きます。ルーターは入ってきたトークンを見て、どのエキスパートに送るかスコアを付けます。上位のいくつかが選ばれ、各エキスパートの出力がそのスコアで重み付けされて合計されます。
選択はトークン単位で、しかも層ごとに別々に行われます。1つの文を処理するあいだにトークンごとに違うエキスパートの組み合わせを通り、同じトークンでも層を上がるにつれて担当が変わります。モデル全体をいくつかのモジュールに分けておき、質問の種類に応じてひとつを選ぶ、という仕組みではありません。
エキスパートはテーマごとに分かれない
名前のせいで生まれる誤解がひとつあります。エキスパートと聞くと、ひとつはコード、ひとつは数学、ひとつは翻訳を担当する姿を思い浮かべがちです。ところが実際に学習されたエキスパートは、そうした人間が読み取れる境界では分かれない傾向があります。分化は起きますが暗黙のうちに起き、その基準はトークンレベルの統計的なパターンに近いものです。
これは実務にも関わってきます。「自社の領域に合うエキスパートだけを切り出して使えばいいのでは」という発想は、たいてい通用しません。エキスパートは単独で完結したモジュールではなく、ルーターと一緒に学習された一部分です。切り離した瞬間に、その組み合わせを前提に作られた表現が崩れてしまいます。
ルーティングが崩れるとき
MoEの学習で繰り返し起きる失敗が、エキスパートの崩壊です。ルーターが少数のエキスパートにばかりトークンを集め、残りはほとんど使われない状態に収束してしまう現象です。こうなると、総パラメータは増やしたのに実際に学習される容量はその一部にとどまります。メモリだけ使って効果は得られないわけです。
従来の対処法は、補助損失を加えることです。エキスパートの使用量が均等に散らばるよう、ペナルティを与える項を目的関数に足します。ただ、この項が本来の学習目標とぶつかり、性能を削ってしまうという問題がついて回ります。DeepSeek-V3が補助損失を使わない負荷分散の方式を打ち出したのは、この文脈においてです。損失の項を足す代わりに、ルーターが出すスコアにバイアス値を持たせ、あまり使われていないエキスパートのほうへその値を少しずつ寄せてバランスを取ります。
コストの構造が変わる
MoEはタダで手に入る効率ではなく、コストの種類を入れ替える選択に近いものです。計算は減りますが、メモリの要求は総パラメータに従い、さらに通信の負担が新たに生まれます。エキスパートが複数のデバイスに散らばっていると、トークンを担当エキスパートのいるデバイスへ送り、結果を受け取る処理が層ごとに繰り返されます。このため、MoEモデルの実際のスループットは、アクセラレーターをつなぐインターコネクトの品質にかなり左右されます。
バッチの構成によって効率がばらつく点も、運用で実感するところです。1つのバッチ内のトークンが別々のエキスパートに散らばると、各エキスパートが処理する量が減り、デバイスの稼働率が落ちます。同じモデルでも、トラフィックのパターンによってトークンあたりの単価が変わる理由はここにあります。
モデルを選ぶ立場からすると、MoEモデルの総パラメータの数字は宣伝文句に近く、実際に見るべきはアクティブパラメータと必要なメモリの2つです。前者が応答速度を、後者がそもそも動かせるかどうかを分けます。
まとめ
MoEは、パラメータと計算を切り離す設計です。同じ計算量でより多くの知識を詰め込めるという点では効率的ですが、メモリは全体のサイズに従い、通信と負荷分散という新しい難しさが加わります。モデルカードに数字が2つ書かれていたら両方を確認し、それぞれが別の制約を意味していることだけ覚えておけば、比較はずっと楽になります。