
チャットボットの答えが1文字ずつ流れてくる様子は演出ではなく、言語モデルが実際に動いている姿そのものです。モデルは次のトークンを1つ選び、そのトークンを付け足した文を読み直して、さらに次のトークンを選びます。この順序は変えずに、待ち時間だけを縮める手法が投機的デコーディング(speculative decoding)です。小さなモデルが数トークンを先に書いておくと、大きなモデルがその下書きをまとめて確認し、合っているところまでを承認します。2022年末から2023年初めにかけてGoogleとDeepMindが相次いで発表し、いまでは主要な推論エンジンに標準機能として入っています。
遅いのは計算ではなく待ち時間のせい
大きなモデルは、トークンを1つ作るたびに数十〜数百GBの重みをメモリからGPUの演算装置へ運ばなければなりません。計算そのものはすぐに終わり、時間の大半はこのデータを運ぶことに使われています。業界ではこの状態を「メモリ帯域幅に律速されている」と表現します。
ここから重要な観察が生まれます。重みを一度読み込んだついでに、トークンを1つだけ計算しても5つ同時に計算しても、かかる時間に大きな差はありません。問題は、次のトークンが前のトークンに依存しているため、まだわからない5つをまとめて計算する方法がないことです。投機的デコーディングは、その5つを誰かが先に推測してくれればいい、という発想から出発しています。
下書きを書き、まとめて確認する
動作は3つの段階に分かれます。
- 下書きの作成。 同じ語彙を使う小さく速いモデル(ドラフトモデル)が、次のトークンを数個、順番に生成します。小さなモデルなので、いくつか書いても大きなモデルの1ステップより短い時間で済みます。
- 一括の確認。 大きなモデル(ターゲットモデル)が下書き全体を1回の計算で読み、各位置で自分が選ぶはずのトークンの確率を同時に求めます。
- 承認と修正。 先頭から下書きのトークンを1つずつ確かめて受け入れていき、最初に食い違った位置で止めて、そこは大きなモデルの選択に差し替えます。それ以降の下書きは捨て、1の段階に戻ります。
下書きがよく当たれば、大きなモデルの1回の計算で複数のトークンが確定します。1つも当たらなくても、少なくとも1トークンは大きなモデル自身が作ったもので進みます。損をするのは、下書きを書くのにかかった時間くらいです。
なぜ答えが変わらないのか
投機的デコーディングの核心となる主張は、「出力の分布が、大きなモデル単独で生成したときと同じ」という点です。Google Researchのレヴィアタン、カルマン、マティアスがICML 2023で発表した元の論文は、下書きのトークンを確率の比に応じて受け入れるか棄却し、棄却した位置では補正した分布からサンプリングし直す方式(修正版の棄却サンプリング)を使えば、結果の分布が数学的に同一になることを示しました。同じ論文は、T5-XXLで出力はそのままに、標準的な実装より2〜3倍速い生成速度を報告しています。
同じ時期にDeepMindも、同じアイデアを投機的サンプリング(speculative sampling)という名前で発表しました。700億パラメータ規模のChinchillaモデルで、要約(XSum)とコード生成(HumanEval)のタスクのデコード速度が2〜2.5倍になり、品質の低下はなかったと報告しています。どちらの研究も、既存のモデルを学習し直したり構造を変えたりする必要がない点を強調しました。
投機的デコーディングは、答えの品質と速度を引き換えにしません。量子化や蒸留がモデル自体を軽くする代わりに精度を少し手放すのとは違い、この手法は同じ答えをより速く受け取る方法です。
下書きは誰が書くのか
当初は同じ系列の小さなモデルを別に用意するやり方が基本でしたが、別のモデルを一緒に動かす負担を減らそうとする派生手法が続きました。
| 方式 | 下書きを書くもの | 特徴 |
|---|---|---|
| ドラフトモデル | 同じ語彙を使う小さなモデル | 実装は単純だが、2つのモデルを一緒にメモリに載せる必要がある |
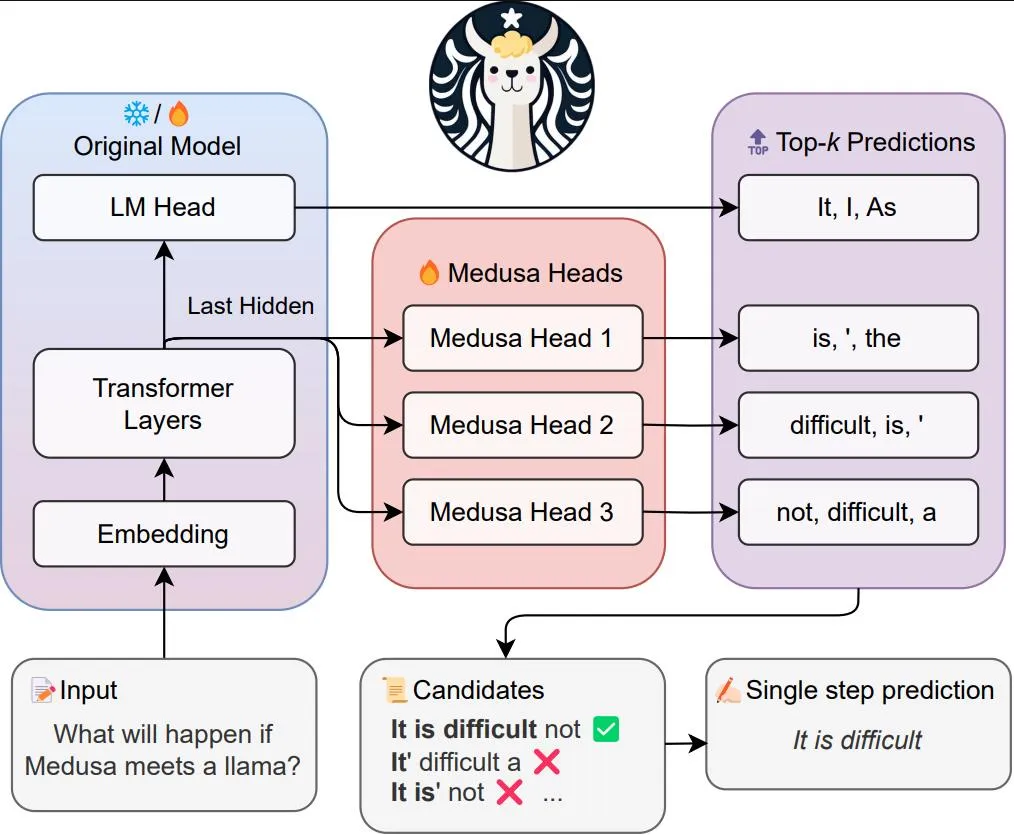
| Medusa | 大きなモデルに付け足した複数の予測ヘッド | 別のモデルなしで、数個先のトークンを同時に予測する |
| EAGLE系 | 大きなモデルの内部表現を入力に受ける浅い下書き用ネットワーク | 下書きの的中率が高めで、最近の推論エンジンでよく使われる |
| n-gram参照 | プロンプトの中にすでにある文字列 | モデルなしで、入力文をそのまま写す区間(要約、コード修正)に効果的 |
Medusaは元のモデルの最後の隠れ状態に小さなヘッドを複数付け、1つ目のヘッドには1つ先、2つ目のヘッドには2つ先のトークンを予測させます。各ヘッドが出した候補を組み合わせて何通りもの下書きを作り、大きなモデルがそのうちいちばん長く当たっている候補を一度に選びます。
効果が小さくなる条件
速度の伸び幅は、結局のところ下書きがどれだけ当たるか(受理率)で決まります。そのため同じ手法でも、状況によって体感がかなり違ってきます。
- 創造的な文章と高いtemperature。 次の単語の選択肢が広いほど、小さなモデルが大きなモデルの選択を当てるのは難しくなります。決まった形式のコードや要約のように予測しやすい出力で効果が大きくなります。
- リクエストが集中するサーバー。 ユーザーのリクエストを大きくまとめて処理するサーバーは、すでにGPUの演算を使い切っているため、余った計算を下書きの確認に回す利点が小さくなります。同時に使うユーザーが少なく、応答の遅延が重視されるサービスのほうが有利です。
- 追加のメモリと運用の負担。 別のドラフトモデルはそのぶんGPUメモリを占め、大きなモデルを替えるたびに、それに合う下書き用のモデルも選び直す必要があります。
- 下書きの長さの調整。 下書きを長くするほど一度に得られるトークンは増えますが、後ろに行くほど外れる確率も上がります。推論エンジンは受理率を指標として表示し、下書きの長さを調整できるようにしています。
実務で見るべきポイント
APIでモデルを使う立場なら、投機的デコーディングを自分でオンにすることはほとんどありません。モデルの提供元がサーバー側ですでに適用していることが多く、結果も変わらないため、ユーザーから見れば応答が速くなったという形でしか表れません。自分たちでモデルをサービングしているチームなら話は別です。vLLM、TensorRT-LLM、SGLangといった推論エンジンがドラフトモデル、EAGLE、n-gramの方式を設定項目として用意しているので、自社サービスの実際のリクエストで受理率と遅延を測って選ぶのが順序です。
コストの面でも意味があります。同じGPUでより短い時間に応答を終えられれば、リアルタイムの問い合わせ対応やコードの自動補完のように遅延に敏感なサービスを、より少ない機材で運用できます。エージェントのようにモデルを何度も続けて呼び出す構成では、ステップごとに縮んだ時間が積み重なり、作業全体の時間の差はさらに大きく開きます。
まとめ
投機的デコーディングは、小さなモデルが下書きを書き、大きなモデルがまとめて確認することで、メモリ待ちで遊んでいたGPUの計算を活用し、生成速度を上げる手法です。出力の分布が大きなモデル単独と同じで品質を手放さない点が、ほかの軽量化の手法との違いです。ただし効果は下書きの的中率とサービスの負荷のかかり方に大きく左右されるため、数字は論文ではなく自分たちのリクエストで測る必要があります。