
人間が書いた公開テキストだけでは次世代のモデルを育てにくい。そうした警告が出てからというもの、モデルが作ったデータで次のモデルを学習させる方法は、実験から標準的な工程に近づきつつあります。事前学習を扱った以前の記事ではこの流れを1段落で触れるにとどめましたが、実務で判断すべきことはもっと多くあります。合成データが実際に効果を上げた領域はどこか、そしてモデルが自分の出力だけを食べて育つと何が崩れるのかを、あらためて整理します。
人間が書いたテキストが足りなくなってきた
研究機関のEpoch AIは2024年に発表した研究で、学習に使える品質の公開された人間のテキストの総量を約300兆トークンと推計しました。不確実性が大きく、90%信頼区間は100兆から1,000兆トークンまで幅広くとられています。同じ研究は、いまの拡大のペースが続けば2026年から2032年の間にこの在庫を使い切り、モデルを過剰に学習させればその時期はさらに早まりうると見ています。
注目したいのは、同じ研究が合成データについて残した但し書きです。合成データが能力を確実に引き上げるという根拠は、まだ数学やコーディングのような比較的狭い領域でしか確認されていない、というものです。データが足りないなら合成データで埋めればいい、という単純な置き換えは成り立たないと読めます。
すでに学習工程の中に入っている
合成データは、すでに主要なモデルの学習段階のあちこちで使われています。公開資料で確認できる代表例は次のとおりです。
| 事例 | 何を合成したか | 公開された結果 |
|---|---|---|
| phi-1(Microsoft、2023年) | GPT-3.5で作った教科書と練習問題10億トークンを、選別したウェブデータ60億トークンと合わせて使用 | 13億パラメータのモデルでHumanEval 50.6%、MBPP 55.5% |
| Nemotron-4 340B(NVIDIA、2024年) | 指示追従と選好学習に使うアライメント用データ | アライメント段階のデータの98%以上が合成。生成パイプラインも公開 |
| 検証できる問題の解答 | 数学の解答、コードとテスト | 正誤を採点器で判定し、正しい解答だけを残す方式として広く使われる |
共通しているのは、やみくもに大量に作って流し込んではいないことです。phi-1は教科書のように構成された高品質なテキストを狙って生成し、Nemotronは報酬モデルで生成物に点数を付けて上位の応答だけを残しました。数学やコードは正解を機械的に確かめられるので、間違った生成物を捨てやすい領域です。合成データが効果を上げたのは、おおむね品質をふるい分ける仕組みが付いていたところでした。
モデル崩壊、自分の出力だけを食べると分布の裾から消えていく
反対側の極端を実験で示したのが、2024年7月にNatureに掲載されたシュマイロフらのモデル崩壊の論文です。研究チームは言語モデルを学習させたあと、そのモデルが生成したテキストで次の世代のモデルを学習させる手順を9世代まで繰り返しました。その結果、世代を重ねるほど元のデータ分布の端、つまりまれにしか出てこない表現や事例から先に消えていきました。モデルはありふれたものをよりありふれたものに、まれなものをよりまれなものにし、後半の世代では同じフレーズを繰り返す出力が目立つようになりました。研究チームは、こうした欠陥は元に戻しにくいと結論づけています。
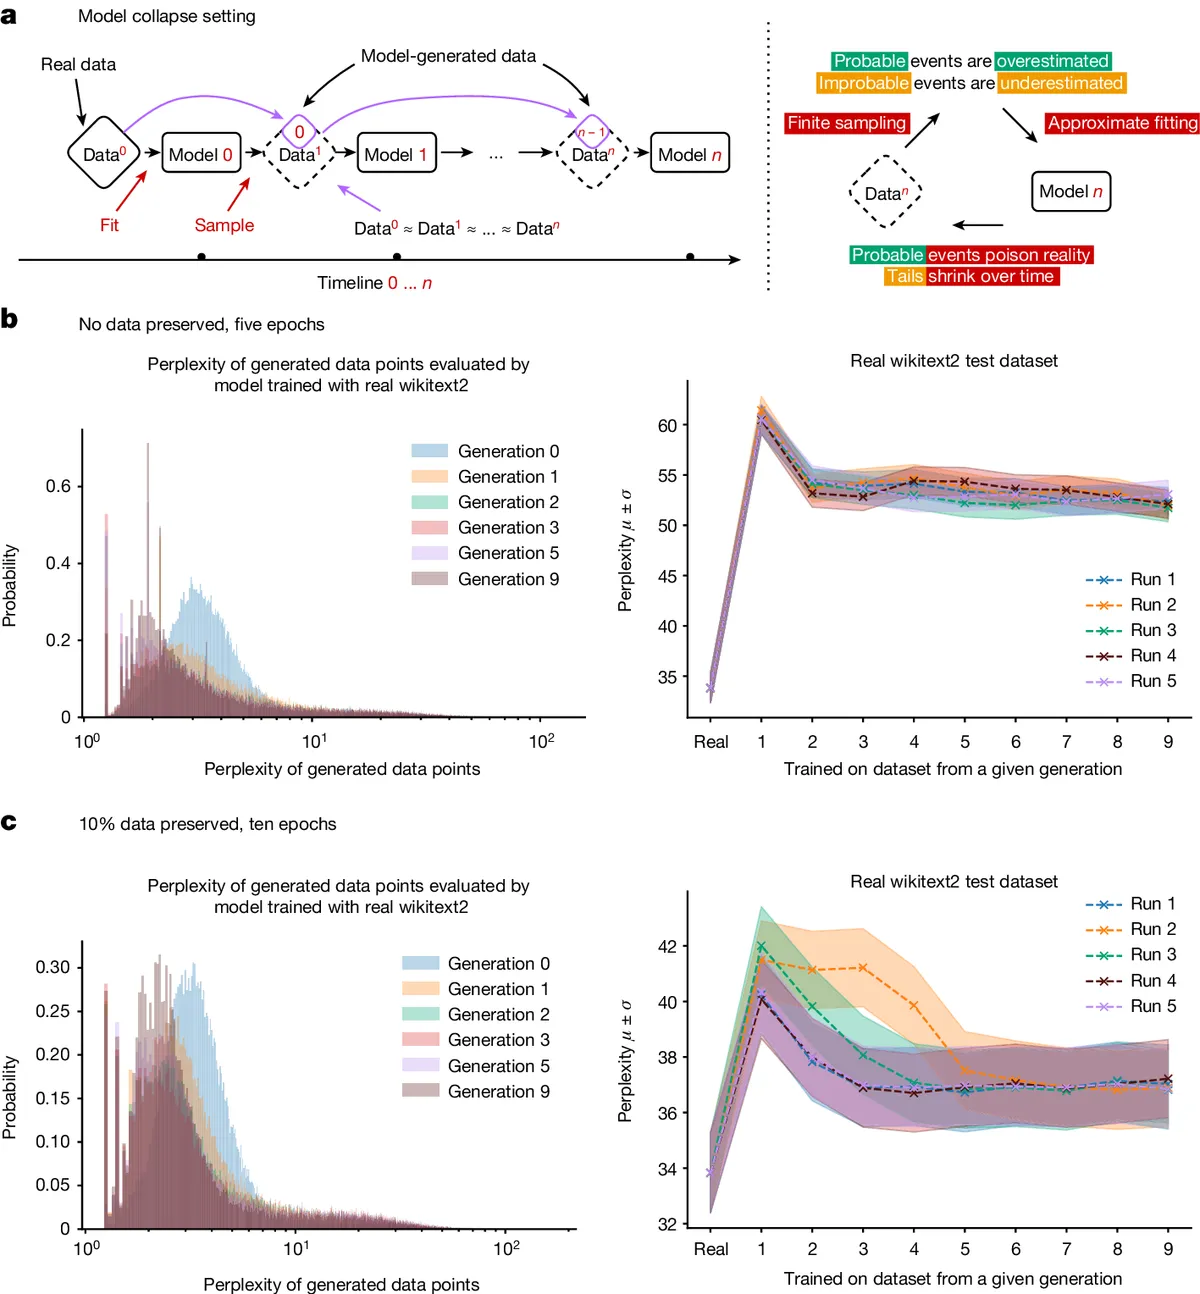
図の右側のグラフが、この論文で実務的にいちばん役に立つ部分です。元データで学習したモデルのパープレキシティは34前後でした。元データをまったく残さず、生成データだけで世代をつないでいくと、パープレキシティは50台から60近くまで上がりました。一方、毎世代の学習データに元データを10%残しておくと、後半の世代のパープレキシティは37前後にとどまりました。崩れる速さを決めたのは、合成データがあること自体より、元データがどれだけ残っているかでした。
置き換えるか、積み上げるか
同じ年のICMLで発表されたゲルストグラッサーらの論文は、この違いを正面から扱いました。毎世代、実データを合成データに置き換えるとモデルは崩壊に向かいますが、元データはそのまま残し、世代ごとに生まれた合成データをその上に積み上げていくと、誤差は一定の水準以上には大きくならないという結果です。研究チームは、言語モデルのほか、画像や分子構造の生成モデルでも似た結果を報告しました。ただし、合成データを何の代償もなく足せるという解釈には反論もあります。積み上げる条件でも性能向上のペースが鈍るという研究が並んで出ており、議論は崩壊するかしないかから、どんな条件でどれだけ損をするかへと移ってきています。
合成データの危うさは、モデルが作ったという事実そのものより、人間が作った元データを置き換えるかどうか、検証なしに混ぜるかどうかにかかっているとみられます。元データを守り、ふるい分ける仕組みを付けた合成データは道具です。どちらもない合成データは、モデルが自分の影を学習するようなものです。
実務で合成データを使うときに確認すること
- 元データを捨てない。 合成データは人間が作ったデータの代わりではなく、その上に足す材料として扱います。ファインチューニング用のデータセットを更新するときも、前のバージョンの元データは残しておきます。
- 検証できるところから使う。 正誤を判定できる分類、抽出、コード、計算のタスクは、生成したあとにふるい分けやすい領域です。正解があいまいな文章作成や問い合わせ対応の応答は、人によるチェックの割合を高めに設定します。
- 出どころを記録する。 どのサンプルがどのモデルで生成されたかをメタデータとして残しておけば、あとで品質の問題が出たときにその部分だけを取り除けます。ウェブから集めたデータにも、すでにほかのモデルの出力が混ざっている前提で扱います。
- 平均スコアだけでなく多様性も測る。 モデル崩壊はまれな事例から消えていくため、平均の正答率には遅れて表れます。少数のカテゴリやロングテールの質問に対する性能を切り分けて追跡します。
まとめ
合成データは、データの枯渇を解決する魔法というより、決まった条件でだけよく効く工程の道具とみるほうが正確です。効果が確認された事例にはどれも品質をふるい分ける仕組みがあり、崩壊が観察された実験はどれも元データを合成物に置き換えたケースでした。組織の中でモデルを調整するときにも、同じ原則が通用します。人間が作った元データを基準点として守り、生成物はふるい分けてから足す。この順序を守れば、リスクのかなりの部分は管理できる範囲に収まります。