
同じモデルを使っているのに、あるチームのコーディングエージェントは毎回期待どおりの結果を出し、別のチームのエージェントは同じミスを繰り返す。その差はモデルではなく、モデルを包む環境から生まれるという見方が広がっています。この環境を意図的に設計することを、ハーネスエンジニアリング(harness engineering)と呼びます。2026年に入ってOpenAIとAnthropicが相次いで実務の事例を公開し、プロンプトエンジニアリングの次の段階の開発技術として定着しつつあります。
エージェントはモデルとハーネスの合計
実務者の間でよく使われる式が「エージェント = モデル + ハーネス」です。ハーネスはモデルを除いた残りすべてを指します。モデルが読む指針や文書、呼び出せるツール、やってはいけないことの境界、結果を検証して返す仕組みが、すべてここに含まれます。
この見方が広まるきっかけになったのが、OpenAIのエンジニアリングブログに載ったハーネスエンジニアリングの記事です。2026年2月に公開されたこの記事でOpenAIのチームは、約5か月間、人がコードを1行も直接書かずに社内向けのベータ版製品を作ってリリースした実験を紹介しました。アプリケーションのロジック、テスト、CIの設定、ドキュメントまでCodexが書き、チームは手で書いた場合の約10分の1の時間で済んだと見積もっています。記事の要点は「人が方向を決め、エージェントが実行する」の一言にまとまります。人の仕事がコードを書くことから、意図を仕様にし、実行に制約をかけ、結果を検証することへ移っていくという意味です。
Anthropicも2025年11月のエンジニアリングブログで、長時間作業するエージェント向けのハーネスを取り上げました。最初のセッションでプロジェクトの骨組みと機能リストを作る初期化エージェントを置き、その後のセッションのコーディングエージェントは進捗記録のファイルとgitの履歴を読んで作業を引き継ぐ、という構成です。コンテキストウィンドウが切り替わるたびに前の作業を忘れてしまう問題を、モデルではなくハーネスで解いた事例として知られています。
ハーネスを構成する4つの層
ハーネスはつかみどころのない概念に見えますが、実際に手を入れるポイントはおおむね4つの層に分かれます。
| 層 | 役割 | 代表的な手段 |
|---|---|---|
| コンテキスト | エージェントが知っておくべきルールと背景を与える | AGENTS.md、CLAUDE.md、設計ドキュメント |
| ツール | エージェントが取れる行動を決める | MCPサーバー、スキル、社内CLI |
| 制約 | やってはいけないことを防ぐ | 権限設定、フック、リンター、構造テスト |
| フィードバック | 結果を測定して次の試行に反映する | テスト、評価ツール、オブザーバビリティツール |
4つの層のうち1つだけが強くても、効果は限られます。ルールファイルをどれだけ長く書いても、検証の仕組みがなければエージェントがルールを守ったかどうかわかりません。評価ツールだけがあってルールがなければ、同じ失敗がひたすら測定されるだけです。
ルールファイル:エージェントが最初に読む文書
最初に手を入れる層は、リポジトリのルートに置くルールファイルです。Codexをはじめ多くのコーディングエージェントはAGENTS.mdを、Claude CodeはCLAUDE.mdをセッションの開始時に読みます。ここにビルドコマンド、コーディング規約、禁止事項、よく間違えるポイントを書きます。
- 短く具体的に。 「きれいに書いて」より「APIレスポンスの型はpackages/typesにだけ定義する」のほうが効きます。
- 繰り返したミスを記録する。 エージェントが同じミスを2回したら、その場でルールに書き移すやり方がよく使われます。
- 目次の役割を持たせる。 長い設計ドキュメントは別に置き、ルールファイルには「この作業ならこの文書を読む」だけを残すほうが、コンテキストを節約できます。
フックとスキル:記憶ではなく強制で
ルールファイルの限界ははっきりしています。モデルが読んで覚えて守る必要があるため、長い作業の途中では抜け落ちることがあります。そこで、必ず守るべきルールはハーネスが強制する形に移すのが最近の流れです。
代表例がClaude Codeのフック(hooks)です。フックは、ツール呼び出しの前後といったライフサイクルの特定のポイントで、ユーザーが決めたシェルコマンドを実行します。ツールの実行前に動くフックは呼び出しそのものを止められるため、「本番サーバーへのデプロイコマンドはブロック」「ファイル保存後にフォーマッターとリンターを実行」といったルールを、モデルの判断に任せず確実に適用できます。
スキルは逆方向の道具です。特定の作業に必要な手順とスクリプトをまとめておくと、エージェントはその作業をするときだけ読み込んで従います。記事の執筆、デプロイ前のチェック、データ移行のように手順が決まった作業を、毎回同じ品質で繰り返させるための手段です。
ハーネスエンジニアリングの核心となる問いは、「このルールはモデルが覚えておくべきものか、システムが強制すべきものか」です。破れば事故につながるルールほど、強制する側に移します。
評価ツール:ハーネスを変えたら測る
ルールファイルを直したりフックを追加したりしたら、結果が本当に良くなったのかを確かめる必要があります。感覚で判断すると、1〜2回の成功例にだまされがちです。この段階で使われるのが、プロンプトやエージェントの評価ツールです。
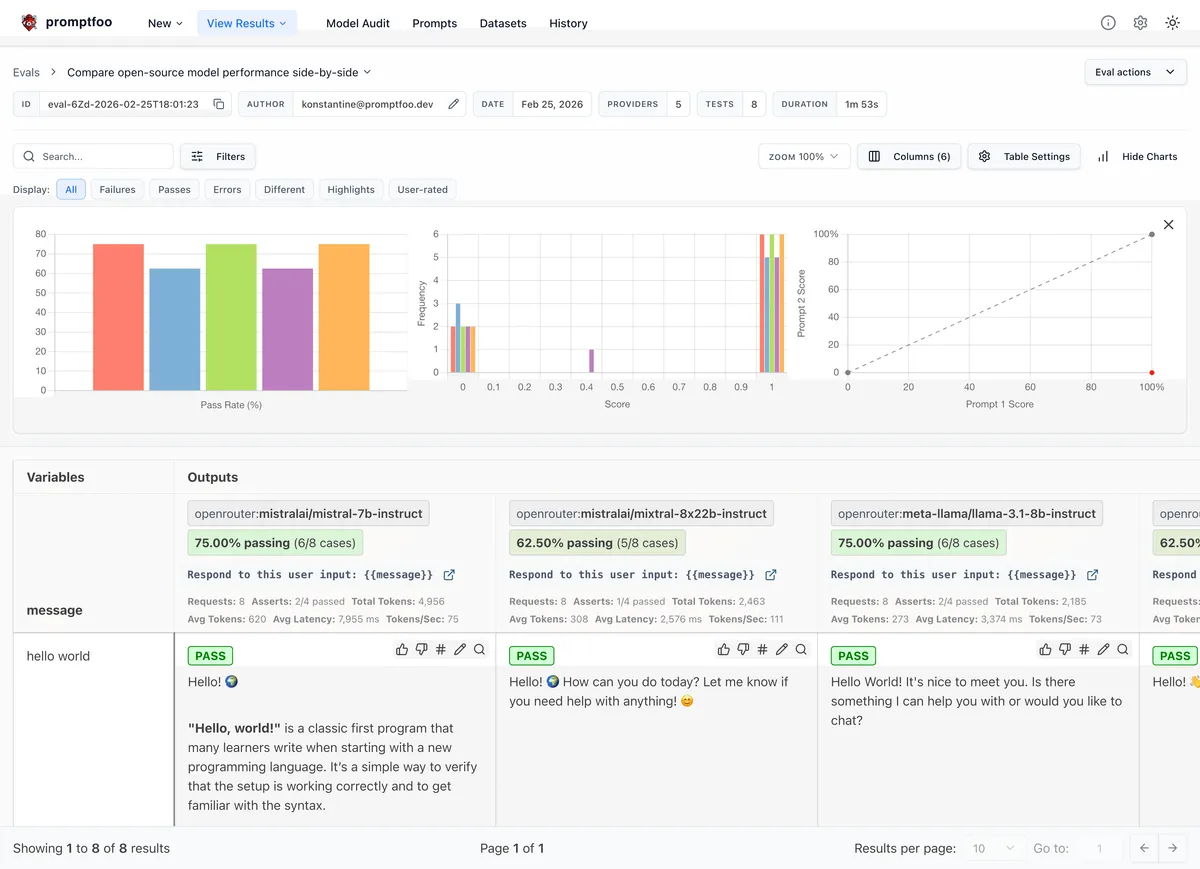
オープンソースの評価ツールpromptfooは、同じタスクを複数のプロンプトとモデルの組み合わせで実行して結果を表で比べ、期待する条件を満たしているかを自動で採点します。MITライセンスで公開されており、2026年にOpenAIに加わったあともオープンソースのまま維持すると表明しています。設定ファイル1つにテストケースをためておけば、ハーネスを変えるたびに同じセットで回帰テストを回せます。
評価と一緒に使われるもうひとつの軸が、オブザーバビリティ(observability)ツールです。LangSmithやLangfuseのようなツールは、エージェントが実際にどの順番でツールを呼び、どこで時間を使い、どこで失敗したかをトレースとして記録します。評価が「結果は良くなったか」を問うものだとすれば、オブザーバビリティは「なぜ失敗したか」を見せてくれます。
ハーネスを自分で組む場合
既存のコーディングエージェントにルールとフックを載せるやり方で足りなければ、ハーネスそのものをコードで作る選択肢があります。Claude Agent SDK、OpenAI Agents SDK、LangGraphがよく使われる出発点です。エージェントのループ、ツールの定義、権限の判断、状態の保存を自分で制御できるため、社内の業務自動化や、製品に組み込むエージェント機能を作るときに主に使われます。
導入の順序はおおむね次のとおりです。
- エージェントが繰り返し間違えるポイントを記録し、ルールファイルに書き移す。
- 破ると事故になるルールを選び、フックや権限設定で強制する。
- 繰り返しの作業をスキルにまとめ、手順を固定する。
- 代表的なタスク10〜20個で評価セットを作り、ハーネスを変えるたびに回す。
- それでも足りなければ、SDKでハーネスを自分で組む。
注意点
- ルールファイルの肥大化。 ルールを足していくだけだと、コンテキストを食いつぶし、ルール同士がぶつかります。定期的に整理し、実際に使われているルールだけを残します。
- フックの副作用。 ファイルを保存するたびに重いチェックをかけると、作業が遅くなります。強制するルールと推奨にとどめるルールを分けます。
- 評価セットの偏り。 簡単なタスクだけで評価すると、ハーネス改善の効果が大きく見えすぎます。実際に失敗した事例を評価セットに入れるほうが正確です。
まとめ
ハーネスエンジニアリングは、モデルの性能競争とは別に、同じモデルからより安定した結果を引き出す技術とみられます。ルールファイルで文脈を与え、フックと権限で境界を強制し、評価ツールとオブザーバビリティツールで効果を測る流れが、実務の標準として定着しつつあります。最初から大がかりな仕組みを作るより、エージェントが2回間違えたポイントをひとつ、ルールやフックに置き換えるところから始めるのが現実的です。