
AI 연산이라고 하면 여전히 NVIDIA GPU가 먼저 떠오른다. 그런데 2025년 말부터 2026년 사이, 구글과 아마존, 마이크로소프트, 메타, OpenAI가 모두 자기 이름을 단 AI 칩을 발표하거나 실제 서비스에 투입했다. 이 칩들은 그래픽 처리에서 출발한 범용 GPU가 아니라, 특정 계산만 빠르게 하도록 설계한 ASIC(주문형 반도체)이다. 빅테크가 GPU를 사면서도 동시에 자기 칩을 만드는 이유는 성능보다 비용과 공급 구조에 있는 것으로 보인다.
GPU와 ASIC, 무엇이 다른가
GPU는 원래 화면의 수많은 점을 동시에 계산하려고 만든 칩이다. 같은 계산을 대량으로 병렬 처리하는 구조가 신경망의 행렬 곱셈과 잘 맞아서 AI의 표준 장비가 됐다. 다만 범용이라는 장점은 곧 비용이기도 하다. 어떤 모델이 와도 돌아가야 하므로, 특정 모델에는 필요 없는 회로와 유연성까지 함께 사게 된다.
ASIC은 반대 방향이다. 자기 회사 모델이 실제로 많이 쓰는 연산과 데이터 형식에 맞춰 회로를 짠다. 범용성은 포기하는 대신, 같은 전력과 면적에서 더 많은 계산을 뽑아내는 것이 목표다.
| 항목 | 범용 GPU | 맞춤형 ASIC |
|---|---|---|
| 설계 기준 | 어떤 모델이든 돌아가야 함 | 자사 모델과 서비스에 맞춤 |
| 구하는 방법 | 칩 회사에서 구매 | 직접 설계, 파운드리에 생산 위탁 |
| 소프트웨어 | CUDA 생태계가 두텁다 | 자체 컴파일러와 런타임을 키워야 함 |
| 강점 | 유연성, 빠른 도입 | 전력·비용 효율, 공급 통제 |
| 약점 | 높은 가격, 공급 부족 | 설계 비용, 모델이 바뀌면 효율 하락 |
빅테크 다섯 곳의 칩
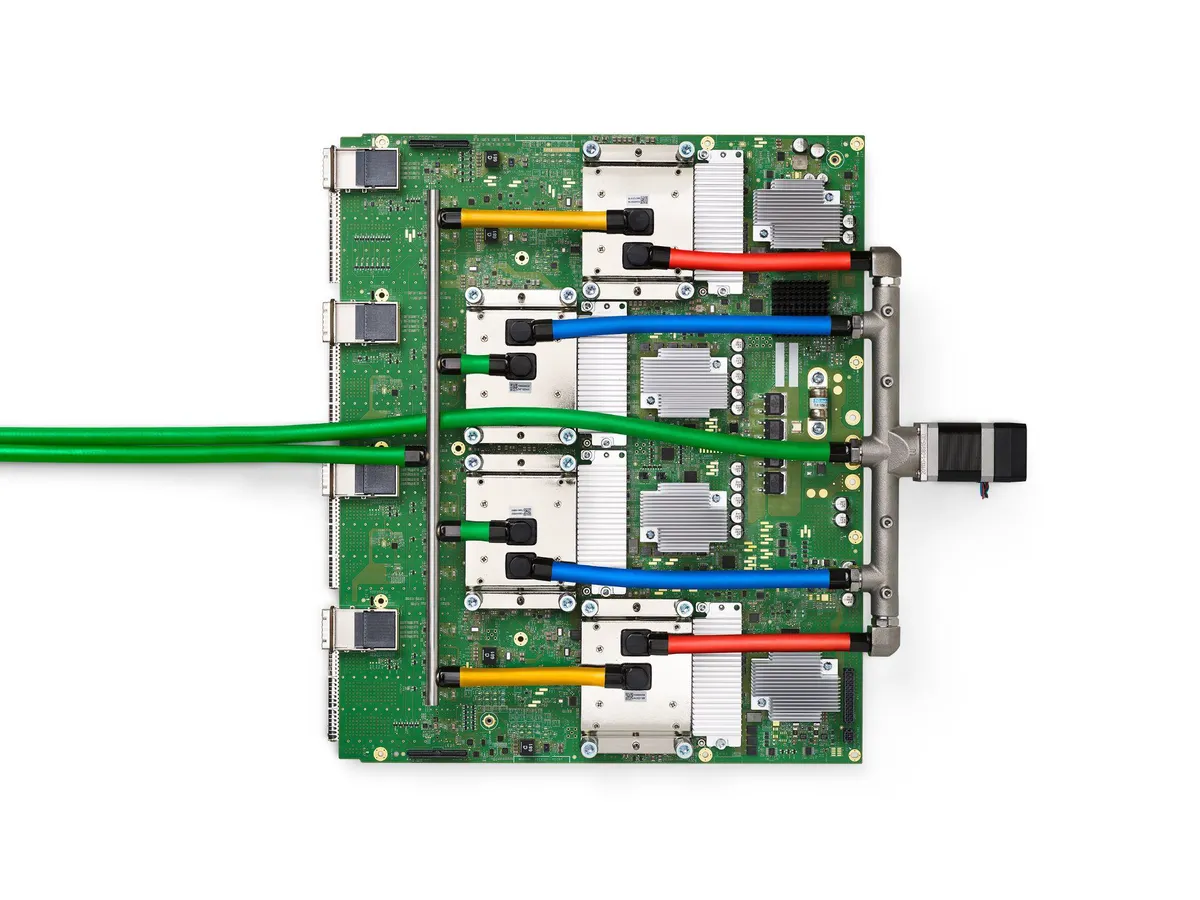
구글은 이 흐름의 선두다. 2015년부터 데이터센터에 TPU를 써 왔고, 7세대 TPU인 Ironwood를 2025년 4월에 공개한 뒤 같은 해 11월 구글 클라우드에서 일반 제공을 시작했다. 구글은 Ironwood를 추론을 위해 설계한 첫 TPU라고 소개하며, 한 포드에 최대 9,216개 칩을 묶을 수 있다고 밝혔다.
다른 회사들도 비슷한 시기에 움직였다.
- 아마존. 2025년 12월 re:Invent에서 3나노 공정의 Trainium3를 일반 제공했다. 서버 한 대에 칩 144개를 묶는 UltraServer 형태로 빌려 쓸 수 있고, 아마존은 학습과 추론 비용을 낮추는 용도로 홍보한다.
- 마이크로소프트. 2026년 1월 추론 전용 칩 Maia 200을 발표했다. TSMC 3나노 공정으로 만들었고, 마이크로소프트는 기존 자사 장비보다 달러당 성능이 30% 높다고 밝혔다.
- 메타. 추천과 추론용 자체 칩 MTIA를 세대별로 이어 가고 있으며, 설계 파트너로 브로드컴과 협력한다.
- OpenAI. 2025년 10월 브로드컴과 10기가와트 규모의 자체 설계 가속기를 배치하기로 발표했다. 2026년 하반기 배치를 시작해 2029년 말까지 마치는 일정이다.
이 칩들은 대부분 TSMC에서 생산된다. 빅테크는 설계를 맡고, 브로드컴이나 마벨 같은 설계 파트너가 실제 칩으로 옮기는 일을 돕는 구조다.
왜 직접 만드는가
가장 큰 이유는 추론 비용이다. 모델을 한 번 학습시키는 비용은 크지만 한정돼 있는 반면, 서비스 이용자가 늘수록 추론 비용은 매일 쌓인다. 추론 모델처럼 답을 내기 전에 더 오래 계산하는 방식이 퍼지면서 이 비중은 더 커졌다. 토큰 하나를 만드는 데 드는 전력과 비용을 몇십 퍼센트만 줄여도, 수십만 대 규모에서는 큰 차이가 된다.
두 번째는 공급이다. 칩플레이션 글에서 다룬 것처럼 AI 반도체 수요가 몰리면서 GPU는 돈이 있어도 제때 구하기 어려운 자원이 됐다. 자체 칩이 있으면 한 회사에 대한 의존을 줄이고 협상력도 생긴다.
세 번째는 전체 시스템 최적화다. 칩만 따로 만드는 것이 아니라 메모리, 인터커넥트, 냉각, 랙 설계까지 자기 데이터센터에 맞춰 한꺼번에 설계할 수 있다. 구글이 TPU를 칩 단위가 아니라 포드 단위로 소개하는 것도 이 때문이다.
맞춤형 칩의 목적은 GPU를 이기는 것이 아니라, 자기 서비스의 토큰당 비용을 남의 가격표에서 떼어 내는 것에 가깝다.
쉽지 않은 이유
그렇다고 모든 회사가 칩을 만들 수 있는 것은 아니다.
- 소프트웨어가 더 어렵다. 개발자들이 익숙한 CUDA 대신 자체 컴파일러와 라이브러리를 써야 한다. 모델 코드를 옮기고 성능을 맞추는 데 드는 엔지니어링 비용이 칩 설계 비용만큼 크다.
- 모델이 바뀌면 효율이 떨어진다. 특정 연산에 맞춘 칩은 모델 구조가 크게 바뀌면 장점이 줄어든다. 설계부터 양산까지 몇 년이 걸리는 동안 AI 모델은 여러 번 바뀐다.
- 규모가 받쳐 줘야 한다. 설계와 검증에 드는 고정비를 회수하려면 칩을 대량으로 써야 한다. 그래서 자체 칩은 거대한 자체 서비스를 가진 회사에서만 성립한다.
이 때문에 빅테크도 GPU 구매를 멈추지 않는다. 대부분은 새 모델 연구와 학습은 GPU에, 이미 굳어진 대규모 추론은 자체 칩에 맡기는 식으로 나눠 쓰는 것으로 알려져 있다.
실무자에게 남는 것
클라우드에서 AI를 쓰는 기업 입장에서 이 흐름은 선택지가 늘어난다는 뜻이다. 구글 클라우드의 TPU나 AWS의 Trainium처럼 클라우드 회사의 자체 칩 인스턴스는 같은 작업을 GPU보다 싸게 돌릴 수 있는 경우가 있다. 다만 프레임워크 호환성과 코드 이전 비용을 함께 따져야 한다.
- 지금 돌리는 작업이 학습인지 추론인지 먼저 나눈다.
- 추론이라면 쓰는 프레임워크가 해당 칩을 공식 지원하는지 확인한다.
- 작은 규모로 같은 모델을 돌려 토큰당 비용과 지연 시간을 직접 비교한다.
정리
빅테크의 맞춤형 AI 칩은 GPU를 대체하려는 시도라기보다, 매일 쌓이는 추론 비용과 GPU 공급 의존을 줄이려는 시도로 보인다. 구글 TPU가 길을 열었고, 아마존, 마이크로소프트, 메타, OpenAI가 2025년부터 2026년 사이 잇따라 뒤를 따랐다. 소프트웨어 생태계와 설계 비용이라는 벽이 있어 당분간은 GPU와 자체 칩을 나눠 쓰는 구도가 이어질 것으로 보인다.