
AIの計算といえば、いまでもまずNVIDIAのGPUが思い浮かびます。ところが2025年末から2026年にかけて、Google、Amazon、Microsoft、Meta、OpenAIがそろって自社の名前を冠したAIチップを発表したり、実際のサービスに投入したりしました。これらのチップは、グラフィックス処理から出発した汎用GPUではなく、特定の計算だけを速くこなすよう設計したASIC(特定用途向け集積回路)です。ビッグテックがGPUを買いながら自社チップも同時に作る理由は、性能よりもコストと供給の構造にあるとみられます。
GPUとASICは何が違うのか
GPUはもともと、画面上の無数の点を同時に計算するために作られたチップです。同じ計算を大量に並列処理する構造がニューラルネットワークの行列積とよく合い、AIの標準的な機材になりました。ただ、汎用であるという長所は、そのままコストでもあります。どんなモデルが来ても動かなければならないので、特定のモデルには不要な回路や柔軟性までまとめて買うことになります。
ASICはその逆です。自社のモデルが実際によく使う演算とデータ形式に合わせて回路を組みます。汎用性をあきらめる代わりに、同じ電力と面積からより多くの計算を引き出すことが狙いです。
| 項目 | 汎用GPU | カスタムASIC |
|---|---|---|
| 設計の基準 | どんなモデルでも動くこと | 自社のモデルとサービスに合わせる |
| 入手方法 | チップメーカーから購入 | 自社で設計し、ファウンドリーに製造を委託 |
| ソフトウェア | CUDAのエコシステムが厚い | 独自のコンパイラーとランタイムを育てる必要がある |
| 強み | 柔軟性、すぐに導入できる | 電力とコストの効率、供給のコントロール |
| 弱み | 高い価格、供給不足 | 設計コスト、モデルが変わると効率が落ちる |
ビッグテック5社のチップ
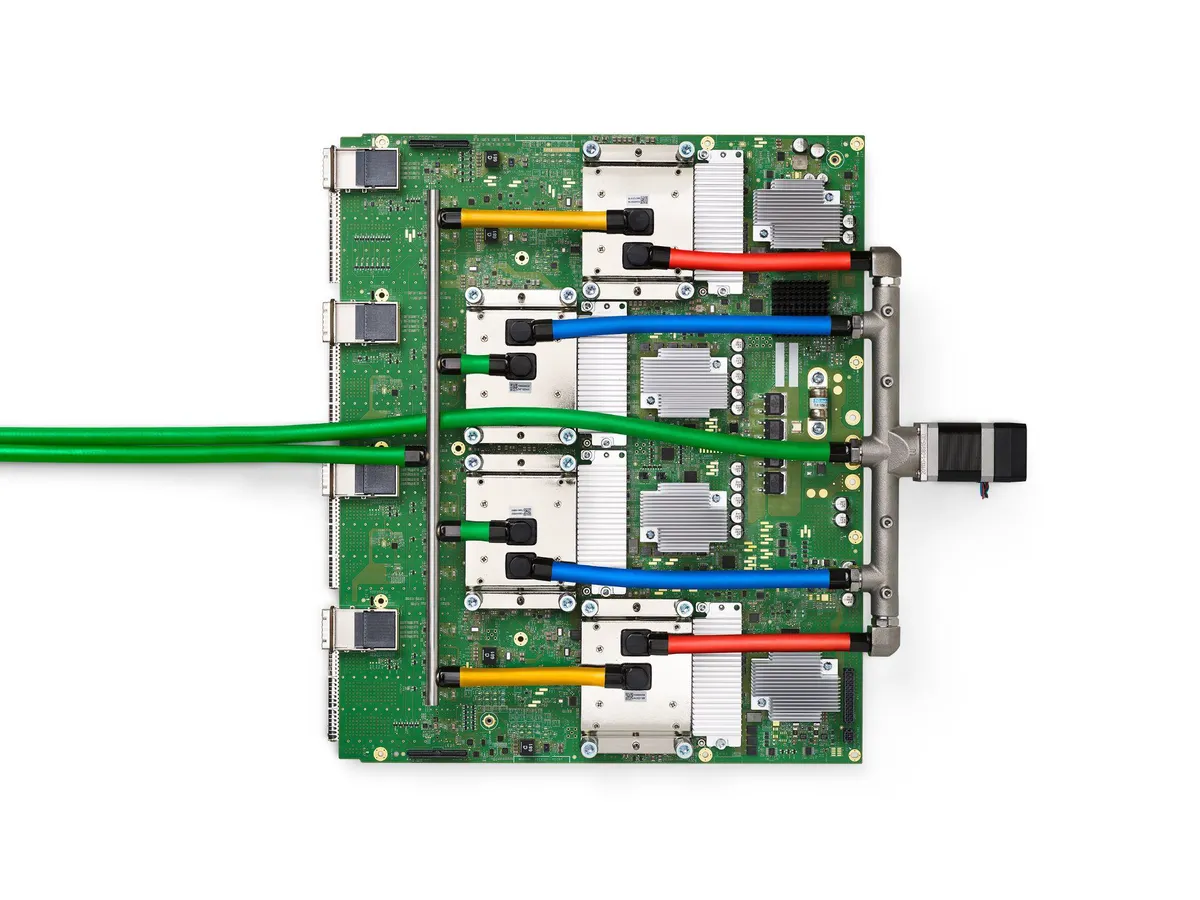
この流れの先頭にいるのがGoogleです。2015年からデータセンターでTPUを使ってきており、第7世代TPUのIronwoodを2025年4月に発表したあと、同じ年の11月にGoogle Cloudで一般提供を始めました。GoogleはIronwoodを推論のために設計した初めてのTPUと紹介し、1つのPodに最大9,216個のチップを束ねられるとしています。
ほかの企業も、ほぼ同じ時期に動きました。
- Amazon。 2025年12月のre:Inventで、3nmプロセスのTrainium3の一般提供を始めました。サーバー1台にチップ144個を束ねたUltraServerの形で借りて使え、Amazonは学習と推論のコストを下げる用途として打ち出しています。
- Microsoft。 2026年1月、推論専用チップのMaia 200を発表しました。TSMCの3nmプロセスで製造され、Microsoftは従来の自社機材より1ドルあたりの性能が30%高いとしています。
- Meta。 レコメンドと推論向けの自社チップMTIAを世代ごとに続けており、設計パートナーとしてBroadcomと協力しています。
- OpenAI。 2025年10月、Broadcomと10ギガワット規模の自社設計アクセラレーターを導入すると発表しました。2026年後半に導入を始め、2029年末までに終える計画です。
これらのチップの多くはTSMCで製造されています。ビッグテックが設計を担い、BroadcomやMarvellのような設計パートナーが実際のチップに落とし込む作業を手伝う構造です。
なぜ自分で作るのか
最大の理由は推論コストです。モデルを一度学習させるコストは大きくても限りがありますが、推論のコストはサービスの利用者が増えるほど毎日積み上がっていきます。推論モデルのように答えを出す前に長く計算する方式が広がり、その比重はさらに大きくなりました。トークン1つを作るのにかかる電力とコストを数十パーセント減らすだけでも、数十万台規模では大きな差になります。
2つ目は供給です。チップフレーションの記事で取り上げたように、AI半導体に需要が集中し、GPUはお金があってもすぐには手に入らない資源になりました。自社チップがあれば、1社への依存を減らし、交渉力も持てます。
3つ目はシステム全体の最適化です。チップだけを単独で作るのではなく、メモリ、インターコネクト、冷却、ラックの設計まで、自社のデータセンターに合わせてまとめて設計できます。GoogleがTPUをチップ単位ではなくPod単位で紹介するのもこのためです。
カスタムチップの目的はGPUに勝つことではなく、自社サービスのトークンあたりのコストを、他社の価格表から切り離すことに近いものです。
簡単ではない理由
だからといって、どの企業でもチップを作れるわけではありません。
- ソフトウェアのほうが難しい。 開発者が慣れたCUDAの代わりに、独自のコンパイラーやライブラリを使わなければなりません。モデルのコードを移植して性能を合わせるエンジニアリングのコストは、チップの設計コストに匹敵します。
- モデルが変わると効率が落ちる。 特定の演算に合わせたチップは、モデルの構造が大きく変わると強みが薄れます。設計から量産までに何年もかかる間に、AIモデルは何度も入れ替わります。
- 規模が支えになる必要がある。 設計と検証にかかる固定費を回収するには、チップを大量に使わなければなりません。そのため自社チップは、巨大な自社サービスを持つ企業でしか成り立ちません。
このため、ビッグテックもGPUの購入をやめてはいません。多くは新しいモデルの研究と学習はGPUに、すでに固まった大規模な推論は自社チップに任せるという形で使い分けていると伝えられています。
実務者にとっての意味
クラウドでAIを使う企業から見れば、この流れは選択肢が増えることを意味します。Google CloudのTPUやAWSのTrainiumのように、クラウド事業者の自社チップのインスタンスは、同じ処理をGPUより安く回せる場合があります。ただし、フレームワークの互換性とコードの移行コストもあわせて検討する必要があります。
- いま動かしている処理が学習なのか推論なのかを、まず分ける。
- 推論なら、使っているフレームワークがそのチップを公式にサポートしているか確認する。
- 小さな規模で同じモデルを動かし、トークンあたりのコストと遅延を直接比べる。
まとめ
ビッグテックのカスタムAIチップは、GPUを置き換えようとする試みというより、毎日積み上がる推論コストとGPUの供給への依存を減らそうとする試みとみられます。GoogleのTPUが道を開き、Amazon、Microsoft、Meta、OpenAIが2025年から2026年にかけて相次いで後に続きました。ソフトウェアのエコシステムと設計コストという壁があるため、当面はGPUと自社チップを使い分ける構図が続きそうです。